即刻App年轻人的同好社区
下载
 置顶
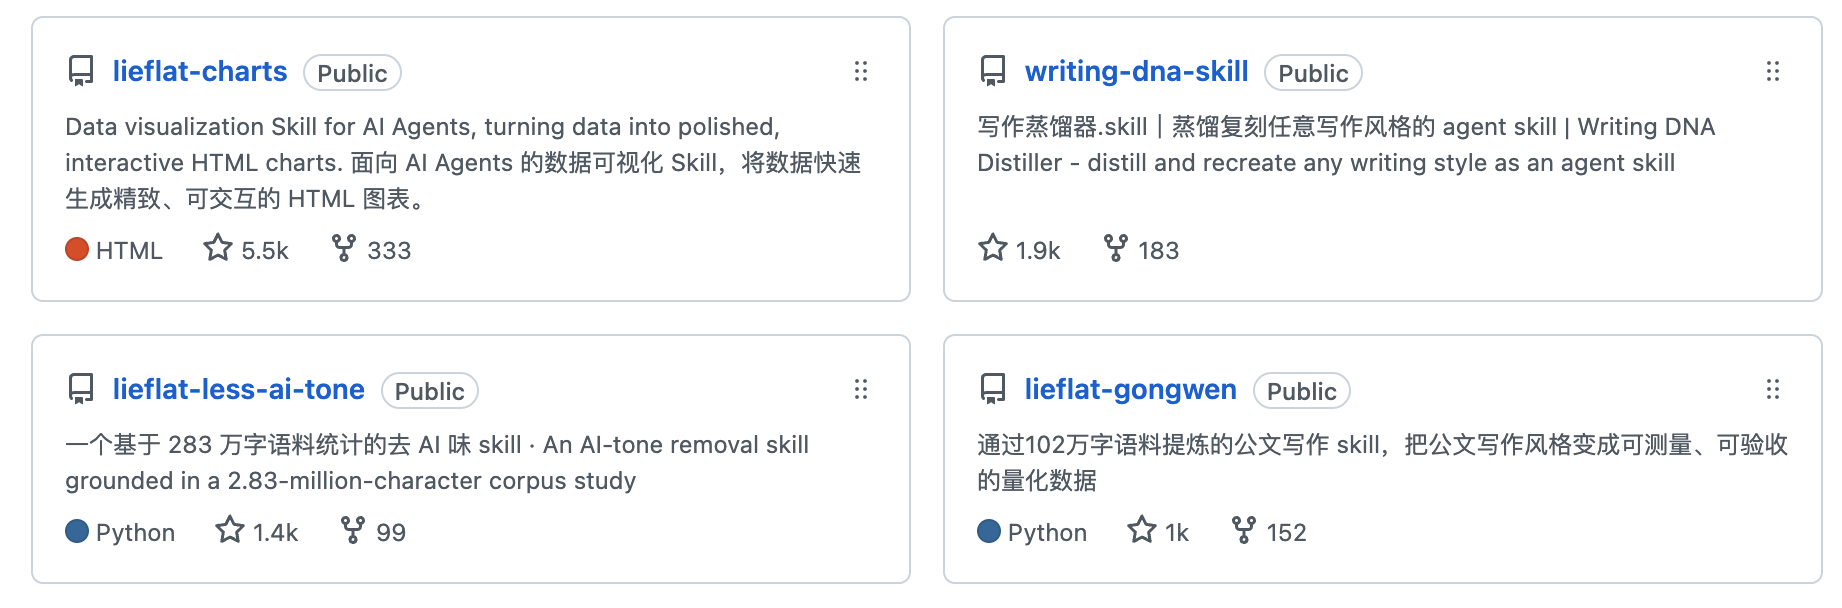
开源了一个可以蒸馏任何写作风格的skill
蒸馏方法只需两步,1.提供或让 agent 抓取20 篇以上希望学习的某个风格的文章,2. 让 agent 用这个 skill 来蒸馏复刻。
GitHub: writing-dna-skill
#AI工作流
蒸馏方法只需两步,1.提供或让 agent 抓取20 篇以上希望学习的某个风格的文章,2. 让 agent 用这个 skill 来蒸馏复刻。
GitHub: writing-dna-skill
#AI工作流


140 2074
我让 Jev 和 opus-5、opus-4.8、terra、luna、gemini 这6个模型同时测评一批文章,看谁能更快找出不恰当的比喻。最后发现,Jev 确实速度很快,标注结果可复用,但是准确度并没有提升,甚至语义理解上不如opus 5。 我一直在做一个 AI 味测评,其中一个重要指标是模型写比喻句(包括明喻、暗喻等)的贴切度。Jev 发布之后,我觉得它很适合用来做模型能力测评和打标,所以我简单做了个小实验,看看它效果到底如何。
我给了这6个模型3篇 AI 写的文章,让它们找出其中不恰当的比喻句。我之前说过,AI 无法真正写作的一个表现是 AI 写不出贴切的比喻。同理, AI 也很难判断什么是好的比喻。一篇有202句的文章,Jev 只花了2.6秒就标注了所有句子,速度确实一骑绝尘。相比之下,opus-5 非推理模式花了8.2秒,gemini花了88.3秒,gpt5.6 terra、luna都在160秒以上。
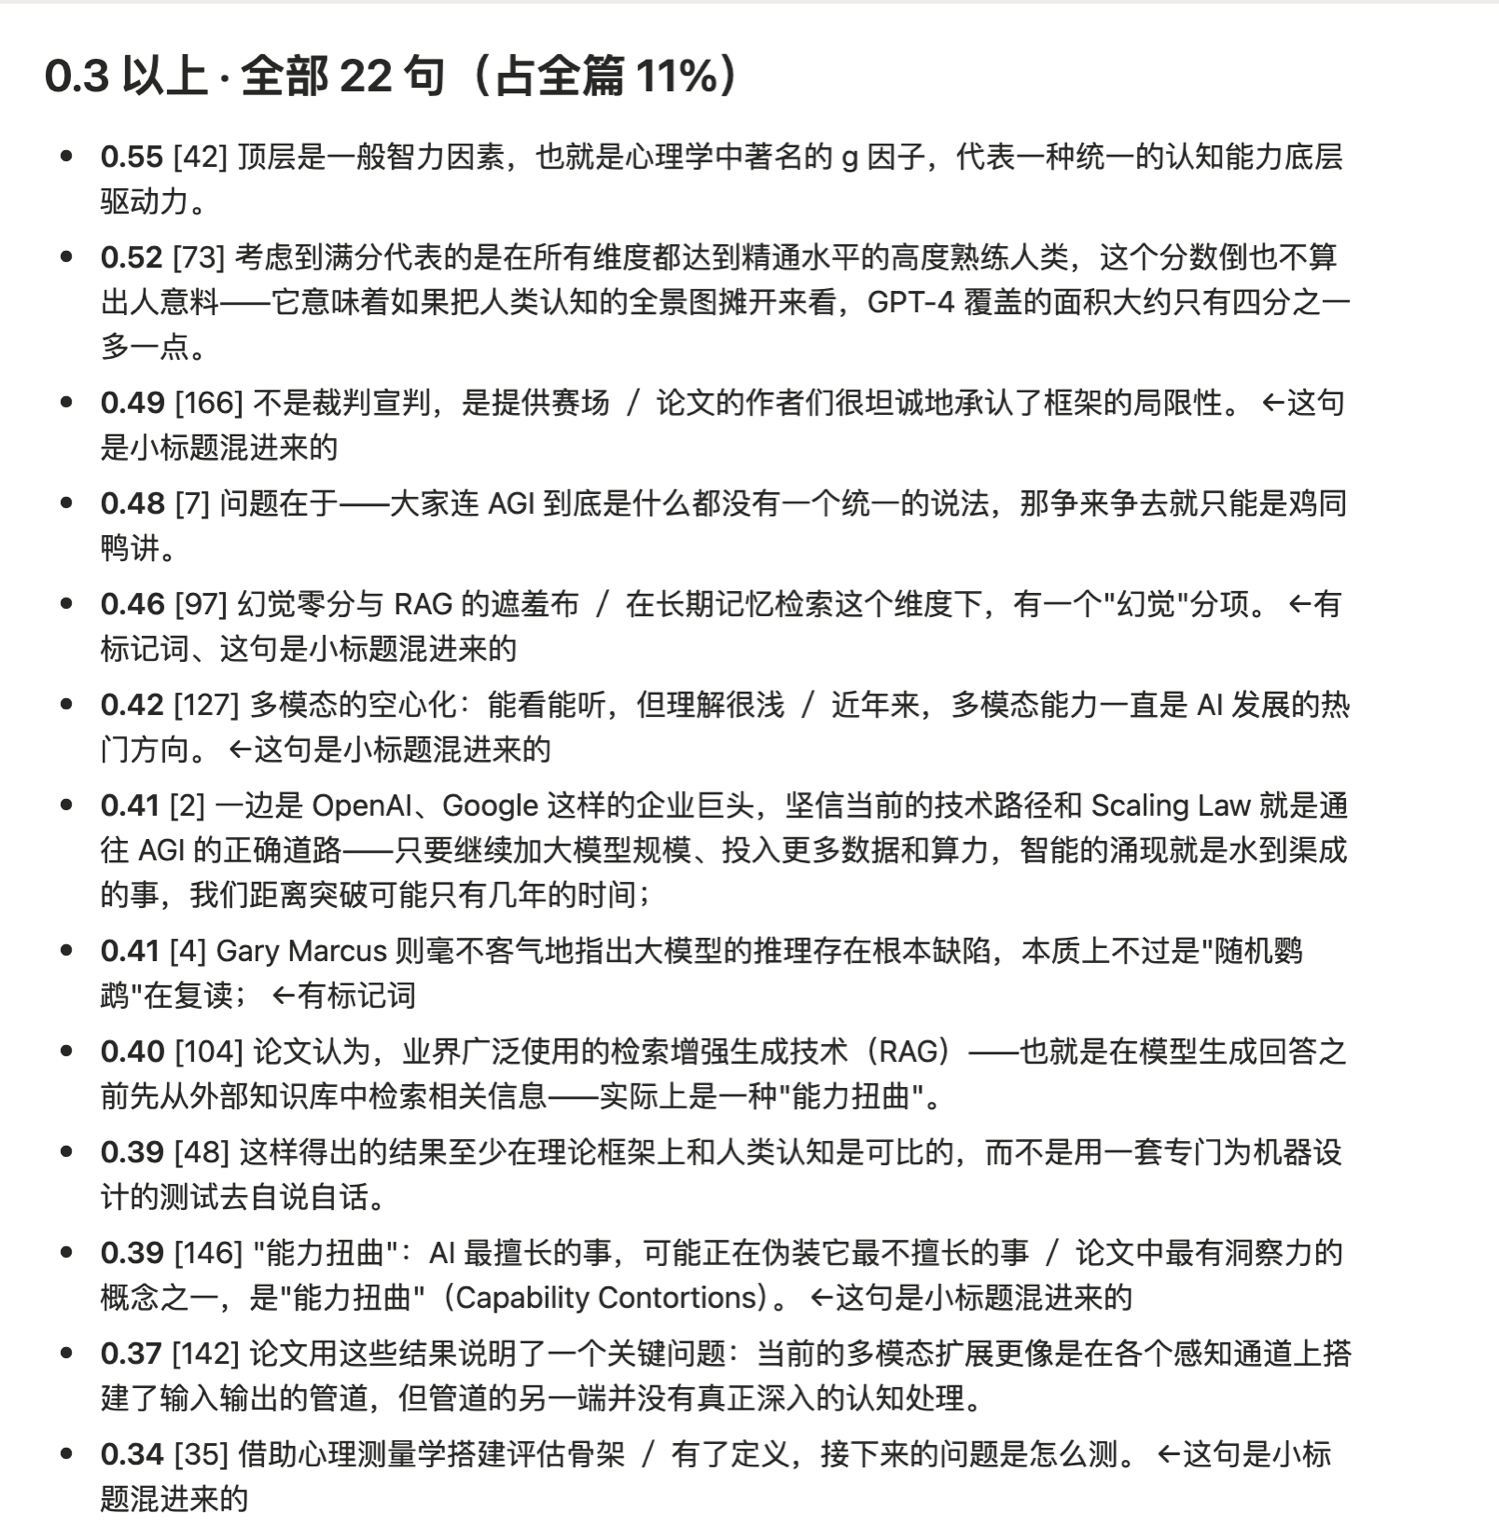
不过,Jev 标注的准确性并没有优于其他模型, Jev 打分最高的最有可能是比喻不贴切的句子,是这句:“顶层是一般智力因素,也就是心理学中著名的 g 因子,代表一种统一的认知能力底层驱动力。”(P1 Jev标注有明显不贴切比喻的句子)
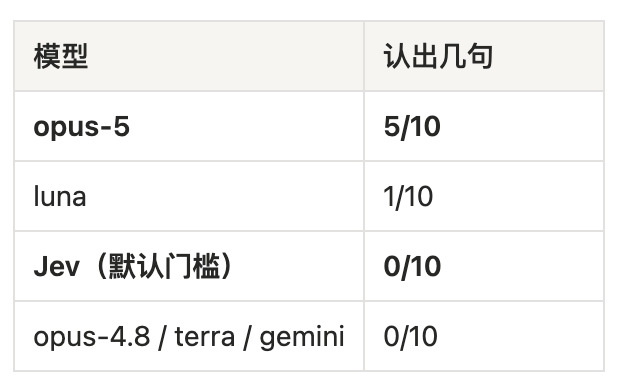
在明显的比喻句上,Jev 找出的概率却很低,例如有 10 句是带明显标记词的(就像、好比、如同、木桶、短板、 遮羞布之类),Jev 一句都没有标注上,opus-5 明显更好,10句里面找到了5句。(P2)
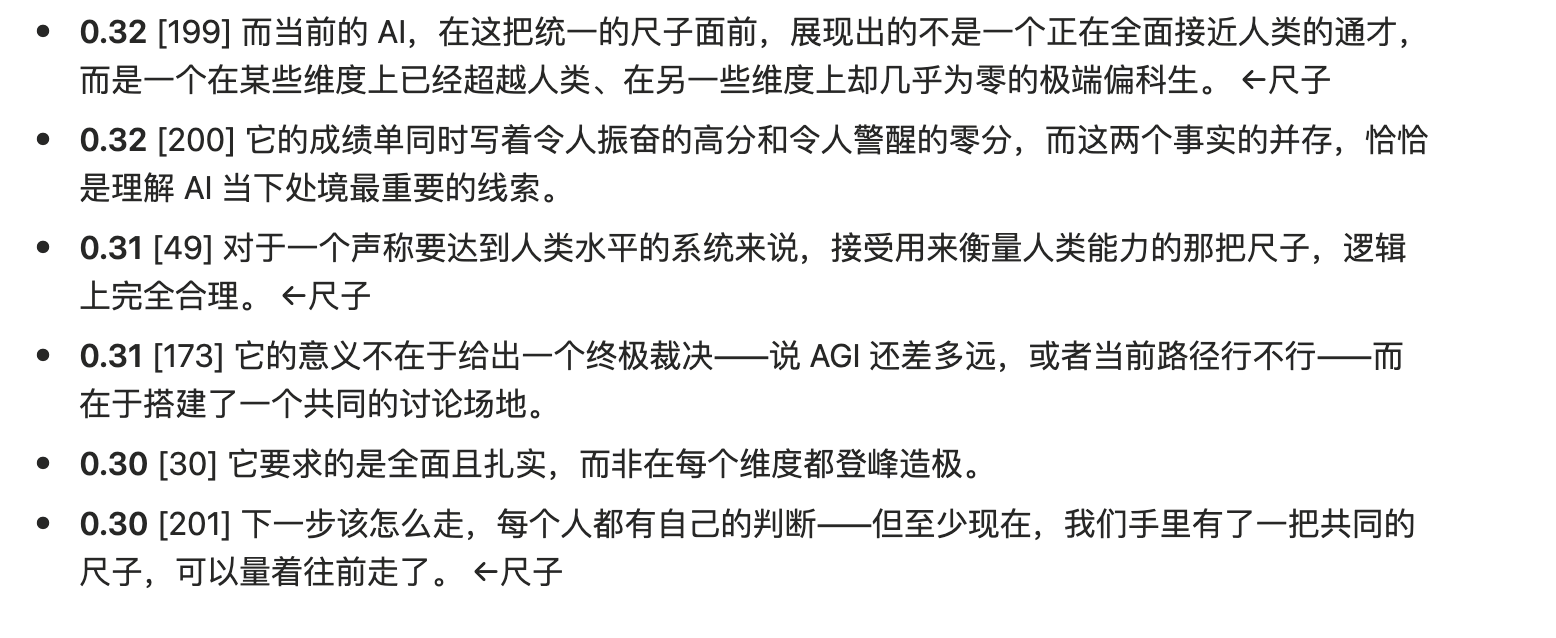
对于多次出现的生硬的“尺子”这一比喻,Jev 的打分只有0.32、0.31、0.30。这是我觉得非常明显的AI滥用比喻的案例,但 Jev 对此并不敏感。(P3)
Jev 当然也有它明确的好处,它输出的是对所有句子的标注,因此我们可以拿着数据做很多分析。但其他模型,输出的只是“哪些句子有不贴切比喻”这一个答案,并不是全量的标注,因此也不能复用。
总之,Jev 在理解比喻这件事上,并没有比其他模型进步多少,甚至可能还不如现有模型。当然,学不会比喻这件事,是所有模型共同的难题。
2 01
有时候我觉得20年也就是一瞬间。当我抱着我的猫的时候,她四仰朝天看着我,一直在呼噜,我不知道该怎么描述这种幸福。但我的心并不是被快乐填满,我想到的竟然是她还能陪我多久,十几二十年后她就不在我身边了。我仿佛瞬间就到了那个时刻,身临其境的悲哀笼罩了我,无论如何我最终都会面临这一天,20年只是一瞬而已。
5 20
AI 无法写作的关键表现之一:AI 无法真正理解和学会比喻。
比喻需要感受,人类会用感受相近的词来比喻,AI 只能通过词频关系来判断。所以现在只能看到一堆牛头不对马嘴的明喻和暗喻,只会给用户增加阅读负担。
比喻需要感受,人类会用感受相近的词来比喻,AI 只能通过词频关系来判断。所以现在只能看到一堆牛头不对马嘴的明喻和暗喻,只会给用户增加阅读负担。

姜汁猴: 几年前我刚开始做记者的时候,一个老记者告诉我一条写作规则:在现场的时候,一定要调动我们的五感,去观察,去感受,这样写出来的东西才是真正有场景感、立体的。 现在,当我通过各种办法调试 AI 写作能力、做去AI味skill的时候,发现 AI 就是写不出人类的感觉,这是因为 AI 没有五感吗? 哪怕现在给AI加上了多模态能力,它事实上也达不到五感的程度,它没有感受,和人类神经系统处理感官的方式完全不同。相比于编程,AI 在写作、在语言表达上的进步太慢了,甚至可能是倒退了。我现在经常看不懂 opus5 输出的报告。 AI 或许永远无法达到人类的写作水平。
4 00
几年前我刚开始做记者的时候,一个老记者告诉我一条写作规则:在现场的时候,一定要调动我们的五感,去观察,去感受,这样写出来的东西才是真正有场景感、立体的。
现在,当我通过各种办法调试 AI 写作能力、做去AI味skill的时候,发现 AI 就是写不出人类的感觉,这是因为 AI 没有五感吗?
哪怕现在给AI加上了多模态能力,它事实上也达不到五感的程度,它没有感受,和人类神经系统处理感官的方式完全不同。相比于编程,AI 在写作、在语言表达上的进步太慢了,甚至可能是倒退了。我现在经常看不懂 opus5 输出的报告。
AI 或许永远无法达到人类的写作水平。
现在,当我通过各种办法调试 AI 写作能力、做去AI味skill的时候,发现 AI 就是写不出人类的感觉,这是因为 AI 没有五感吗?
哪怕现在给AI加上了多模态能力,它事实上也达不到五感的程度,它没有感受,和人类神经系统处理感官的方式完全不同。相比于编程,AI 在写作、在语言表达上的进步太慢了,甚至可能是倒退了。我现在经常看不懂 opus5 输出的报告。
AI 或许永远无法达到人类的写作水平。
7 21
我以为grok bot 这么火是有什么很创新的东西…用了之后发现还是老功能,只是界面确实做得简单了,是我用得不对吗?它有什么codex/claudecode完全没覆盖的能力吗…
对这些大差不差的AI产品甚至都没什么尝试的动力了…
对这些大差不差的AI产品甚至都没什么尝试的动力了…
4 31