即刻App年轻人的同好社区
下载
端午回老家之后,使用手机让 Codex 远程工作,虽然不是不能用,但体感上仍有诸多不便,,此时突然 get 到了 iPhone Duo 的优势!大屏展开,指挥 AI,一切皆有可能!
1 00
判断 Codex 重置对自己是赚了还是亏了,有个很简单的公式。
每周的日均额度是 100 / 7 ≈ 14.29%,用一周剩余的日均额度对比14.29%,大于就是亏了,小于就是赚了。
比如前3天用了20%,剩余4天,日均可用额度是20%,此时重置,未来7天的日均额度降为 14.29%,就亏了。
每周的日均额度是 100 / 7 ≈ 14.29%,用一周剩余的日均额度对比14.29%,大于就是亏了,小于就是赚了。
比如前3天用了20%,剩余4天,日均可用额度是20%,此时重置,未来7天的日均额度降为 14.29%,就亏了。
0 00
日均1亿token,我的Codex配置
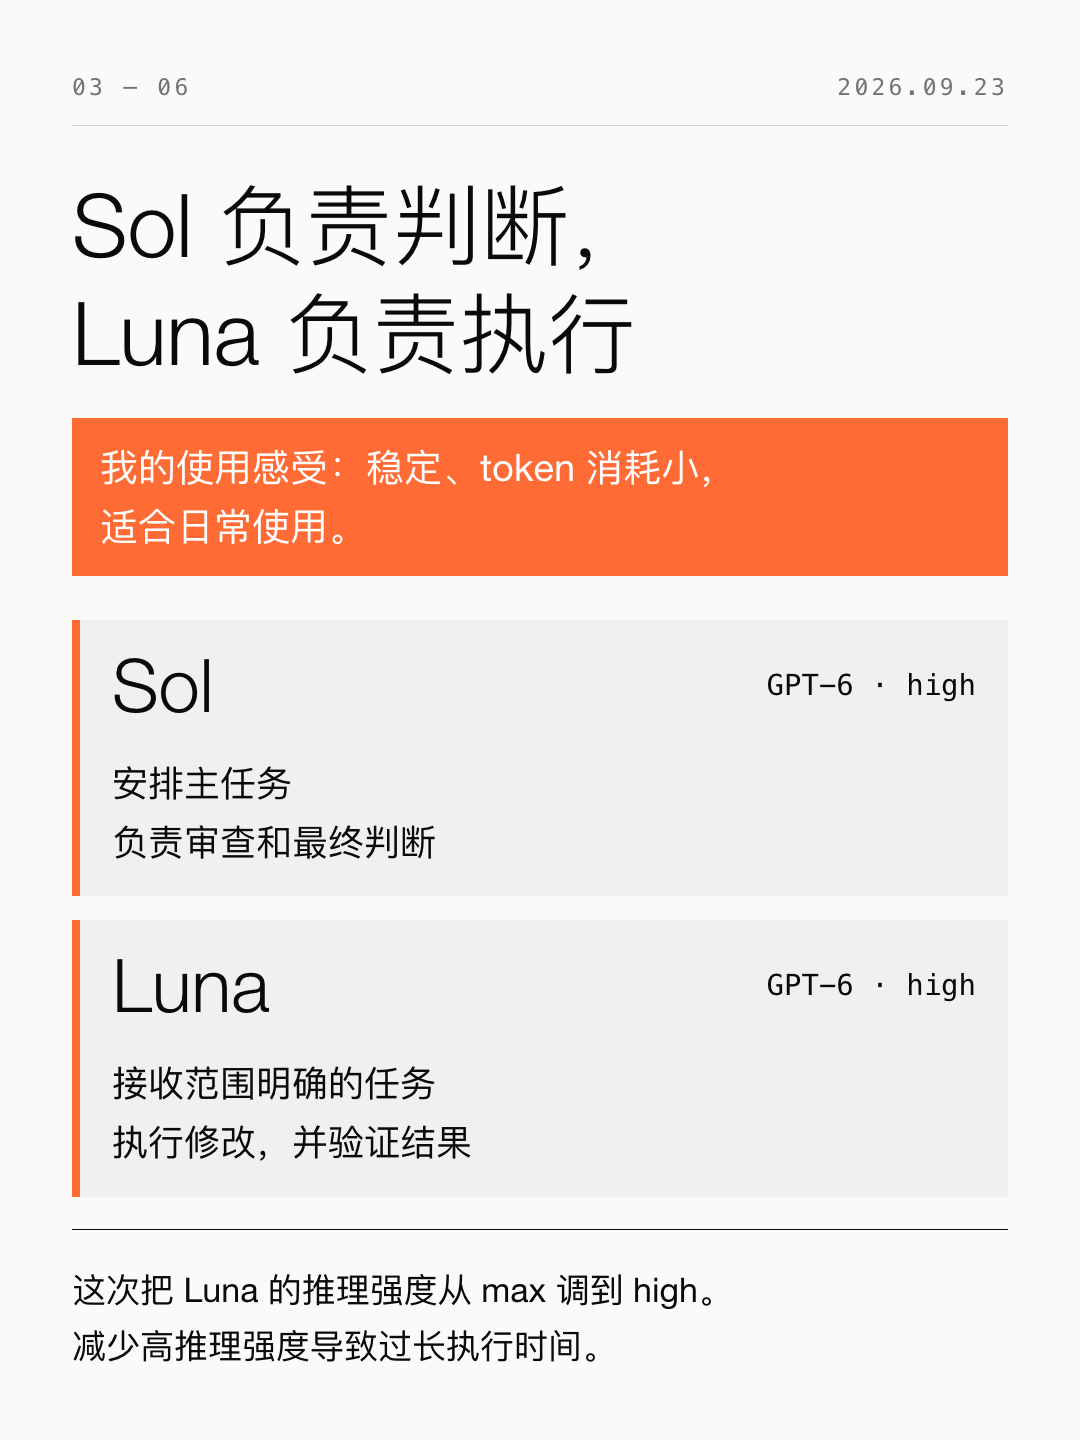
日常用 Codex,我最常用的分工是:Sol 负责安排任务和判断,Luna 接手范围明确的执行工作。这次 GPT-6 Sol 和 Luna 更新后,我也重新整理了自己的配置。
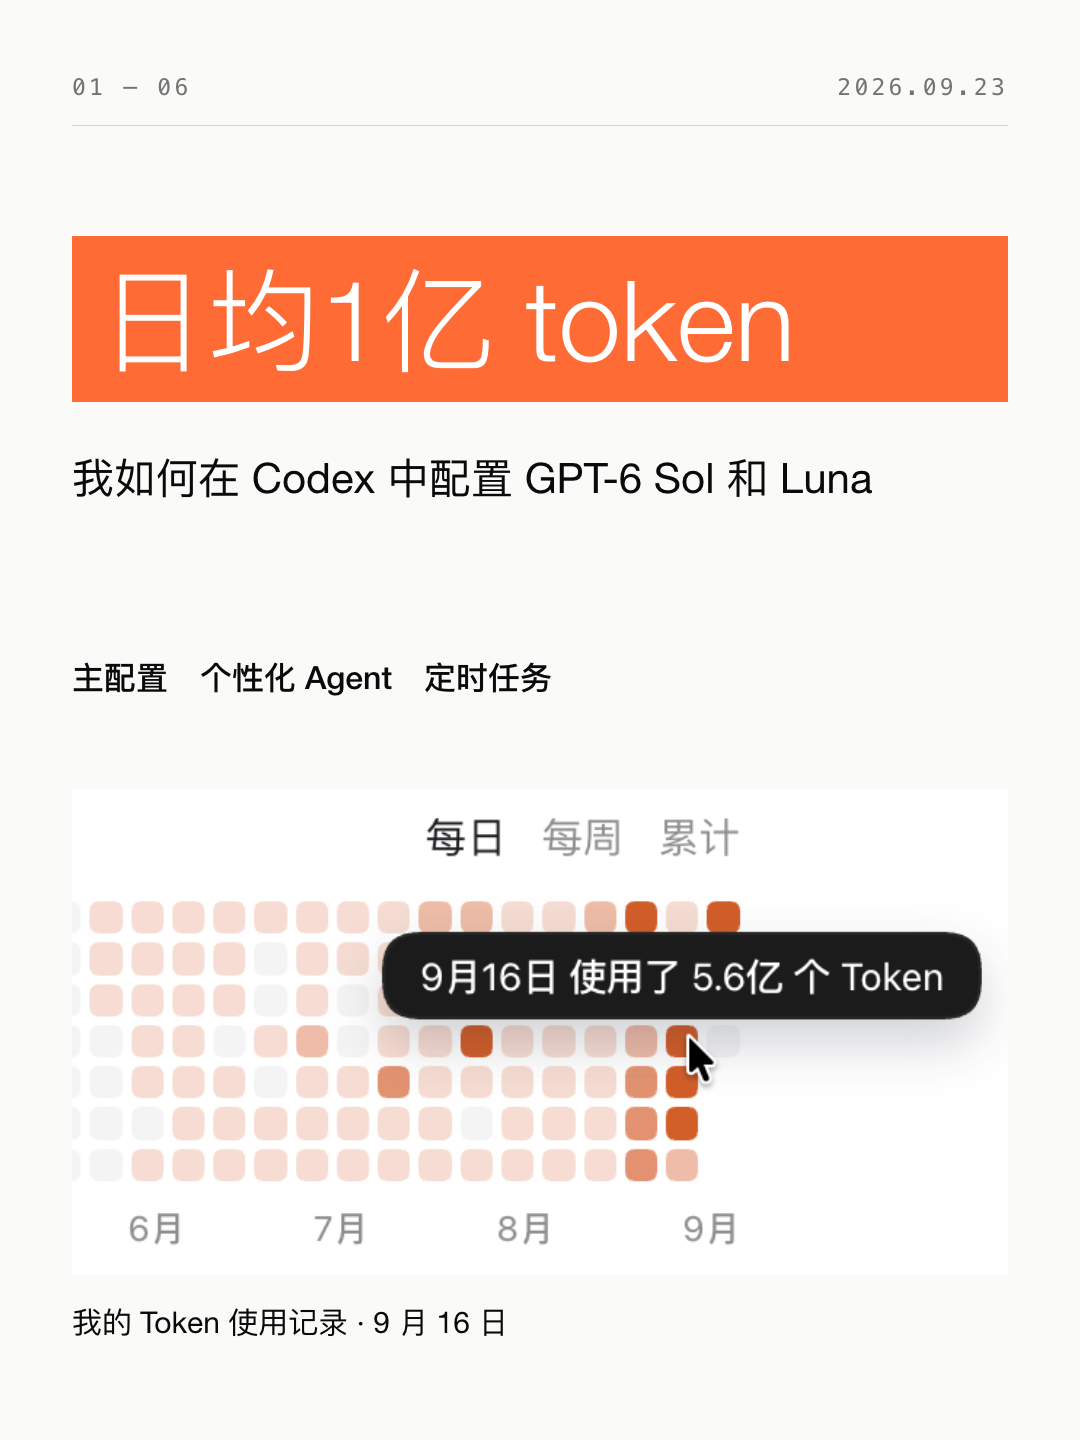
我从 6 月开始使用,日均接近 1 亿 token,截图记录的是 9 月 16 日的 5.6 亿。这些数字是我个人的使用记录。此前长期使用的是 GPT-5.6 Sol high 和 Luna max;我的感受是,这个组合稳定、token 消耗小,适合日常使用。新换的 GPT-6 配置还没有经过实际任务验证,效果留待后续观察。
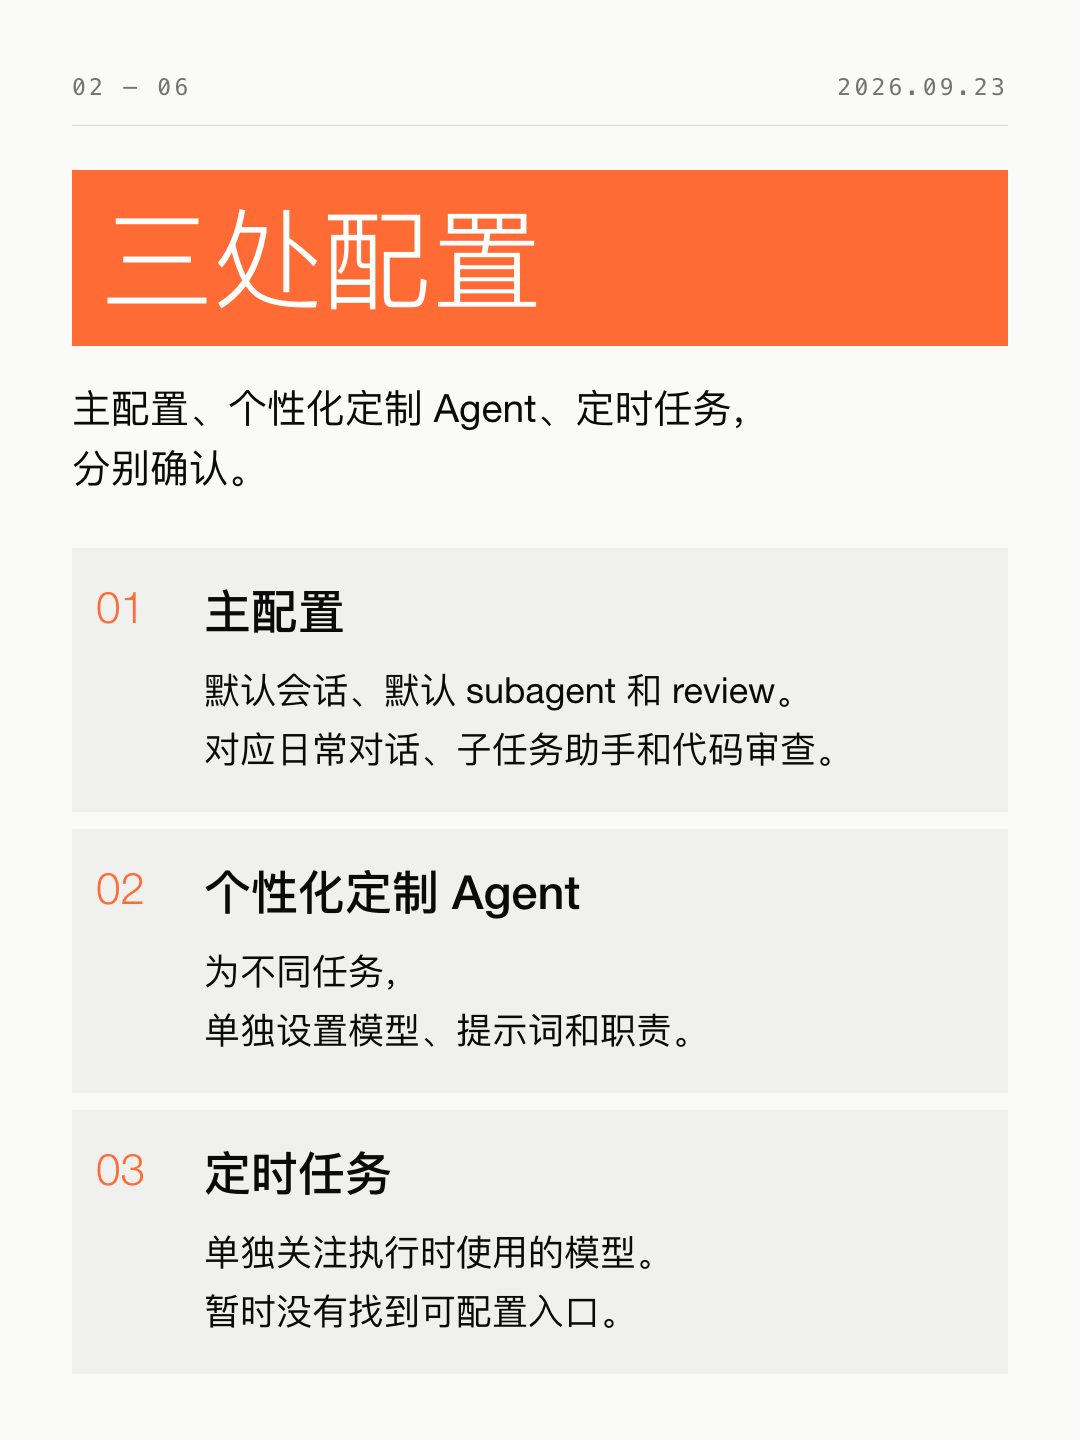
配置时,我会分三个地方看。
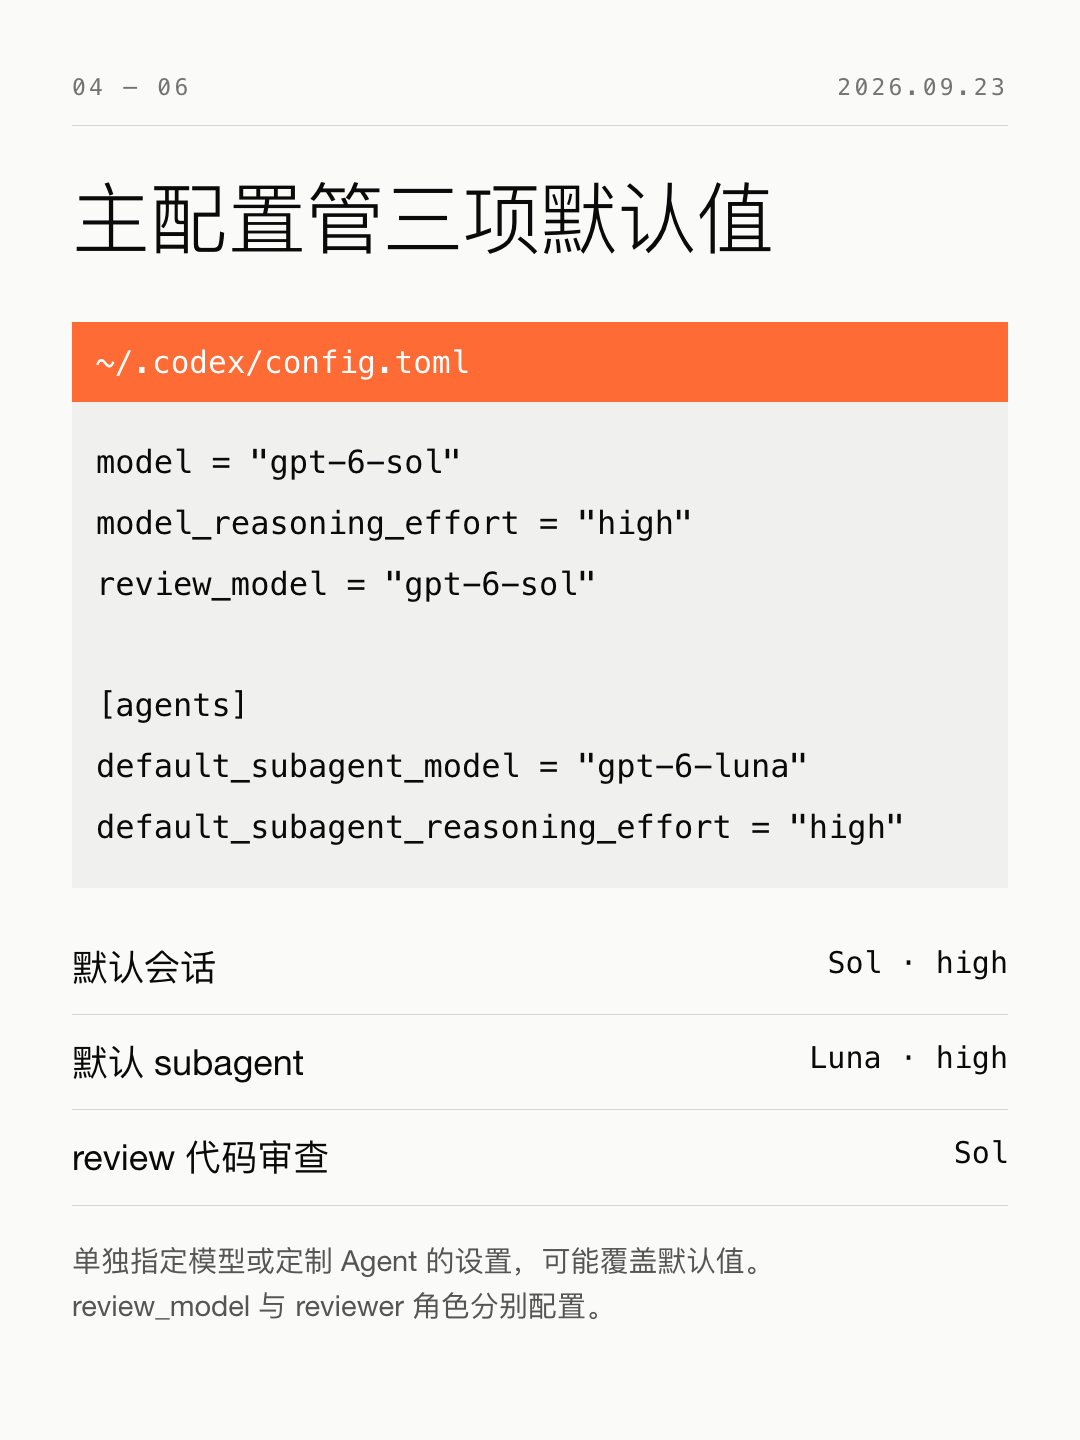
第一处是主配置 ~/.codex/config.toml。它影响默认会话、默认 subagent 和 review。我当前的设置是会话用 Sol high,默认子任务助手用 Luna high,review 用 Sol。
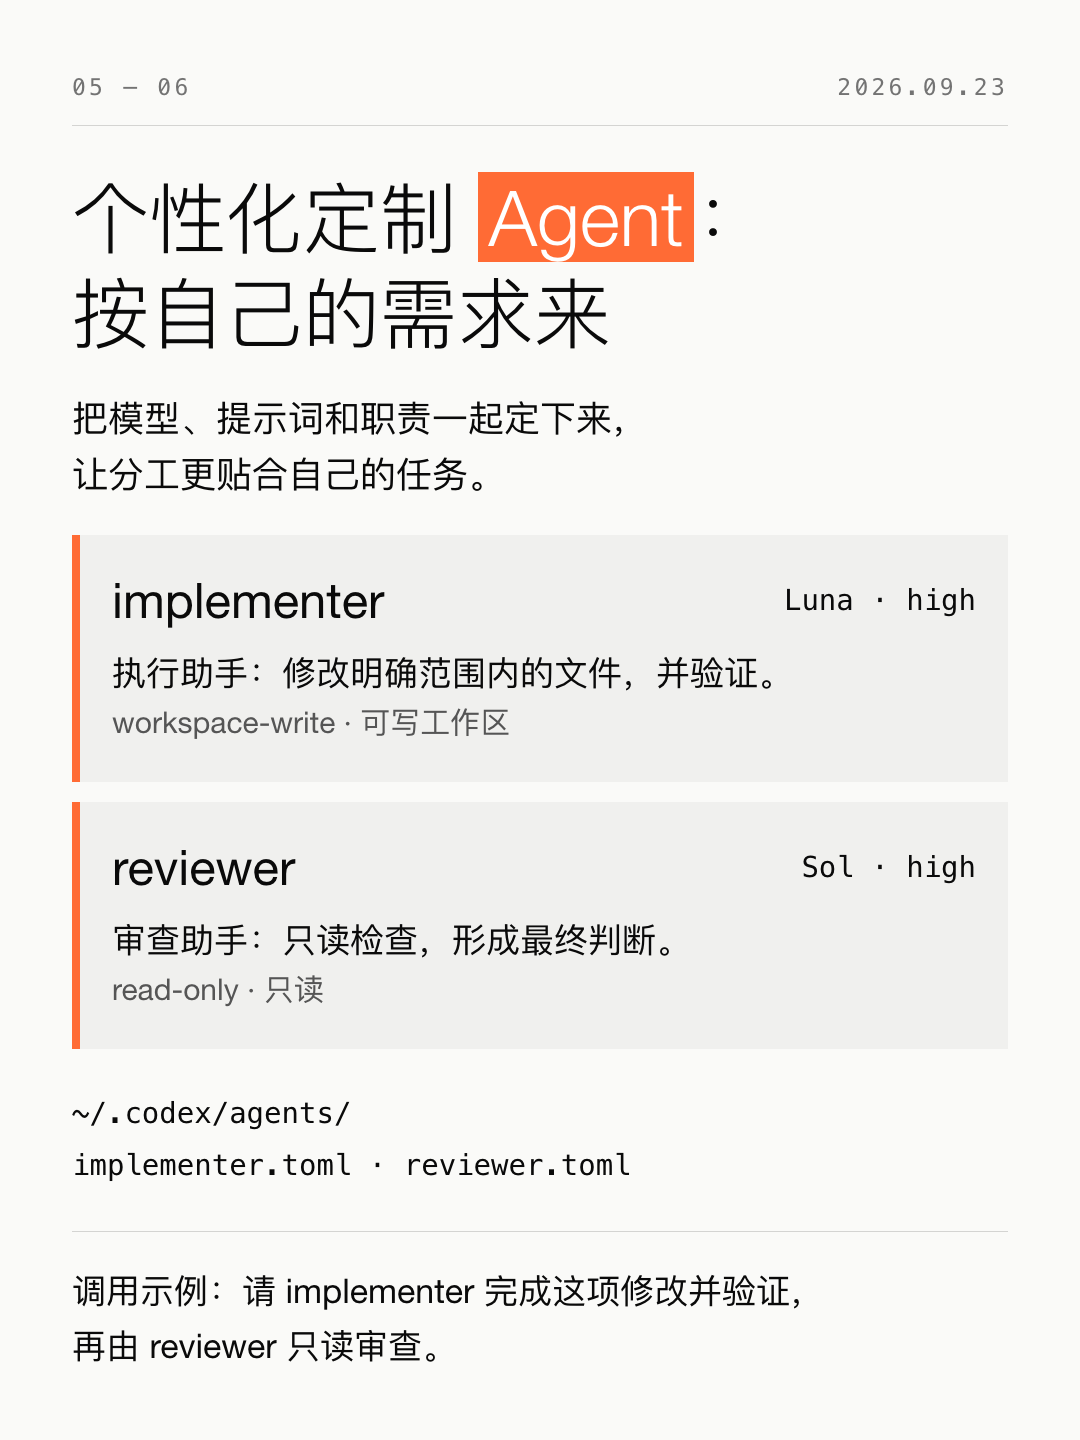
第二处是个性化定制 Agent。我把两个角色放在 ~/.codex/agents/:implementer 用 Luna high,负责按明确要求修改并验证;reviewer 用 Sol high,负责只读审查和最终判断。对我来说,单独配置的好处,是能把自己的要求写进提示词:负责什么、允许修改哪里、怎样判断任务完成。调用时直接点名角色,任务要求也更清楚。
这次我还把 Luna 的推理强度从 max 调到 high。之前有时一个简单改动也要跑十几分钟,所以想先调整强度,继续观察完成质量和耗时。目前没有量化对照,也不把自己的感受扩展成普遍结论。
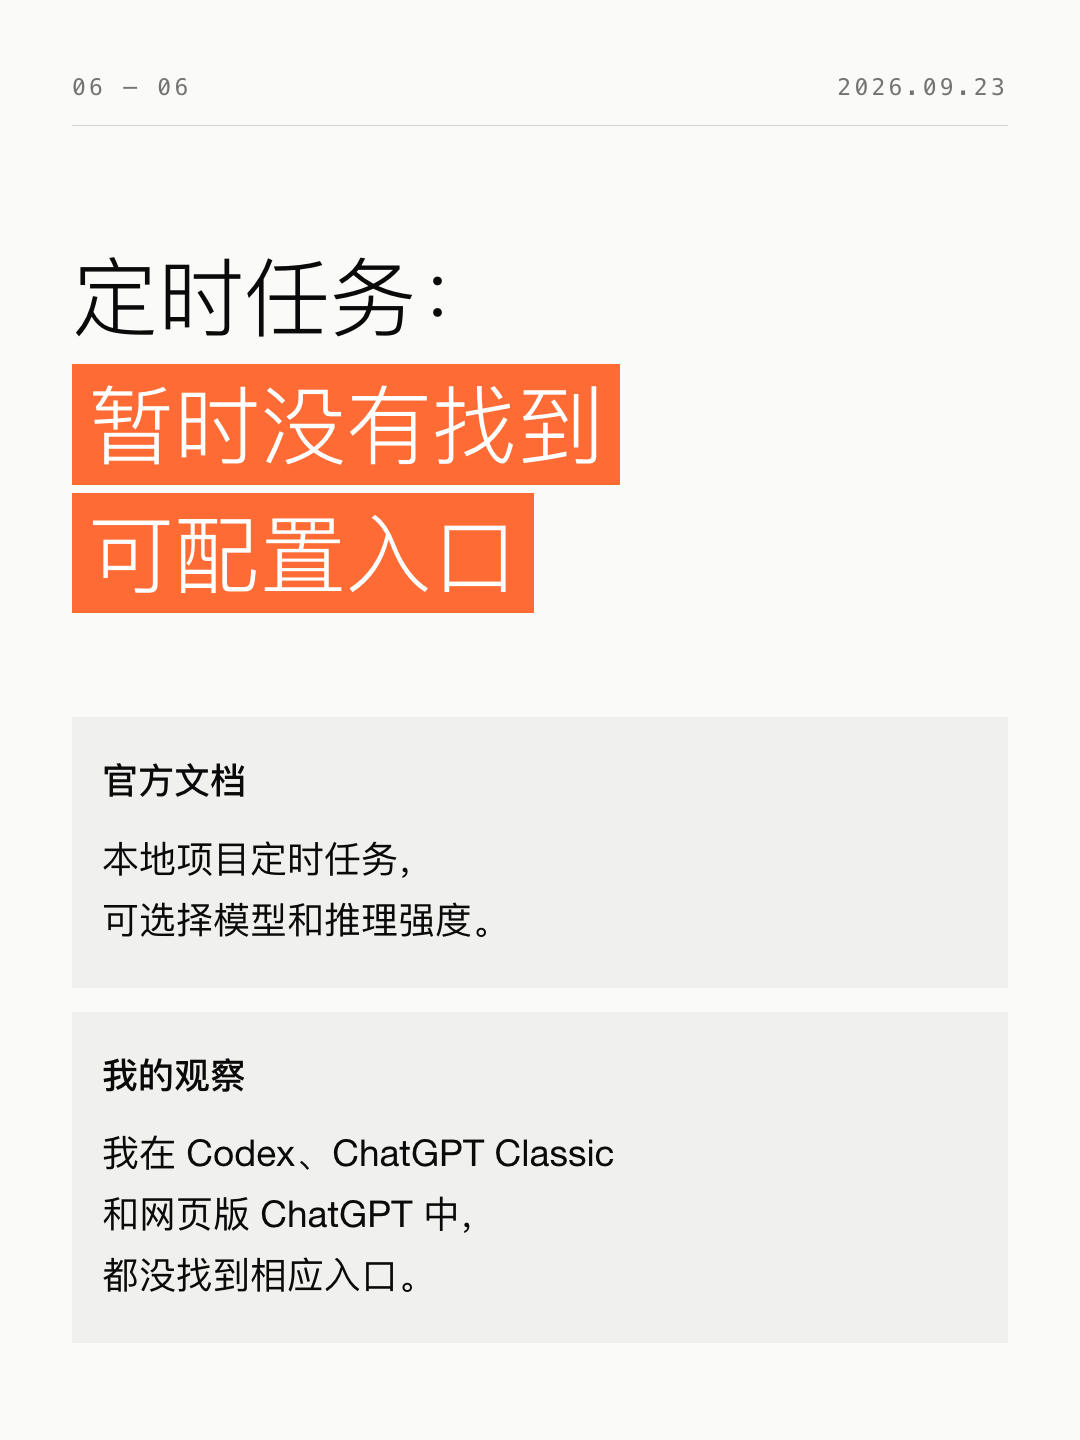
第三处是定时任务。官方文档写明,本地项目任务可以选择模型和推理强度,但我当时在 Codex、ChatGPT Classic 和网页版里都没找到入口。后续执行究竟怎样选择模型,我还没有确认,先把这个观察记下来。
0 00
本周又开发了两个日常的 AI 使用场景,一个是让 Agent 根据我的工作需求在 Ardot 中实现了 H5 原型页面,一个是让 Agent 在 Ardot 中先创建个人项目的原型页面,经过调整确认后再回写到代码中,两种方式效果都很好,都与 Ardot 有关。这也让我意识到具有 AI 能力(不管是软件原生还是通过 MCP 接入)的设计软件,在产品经理日常工作中的重要性。
从设计到代码,我用 Codex 和 Ardot 重做了一遍应用界面
0 00
DeepSeek Harness 9月15日更新:从聊天窗口走向 Agent 工作台
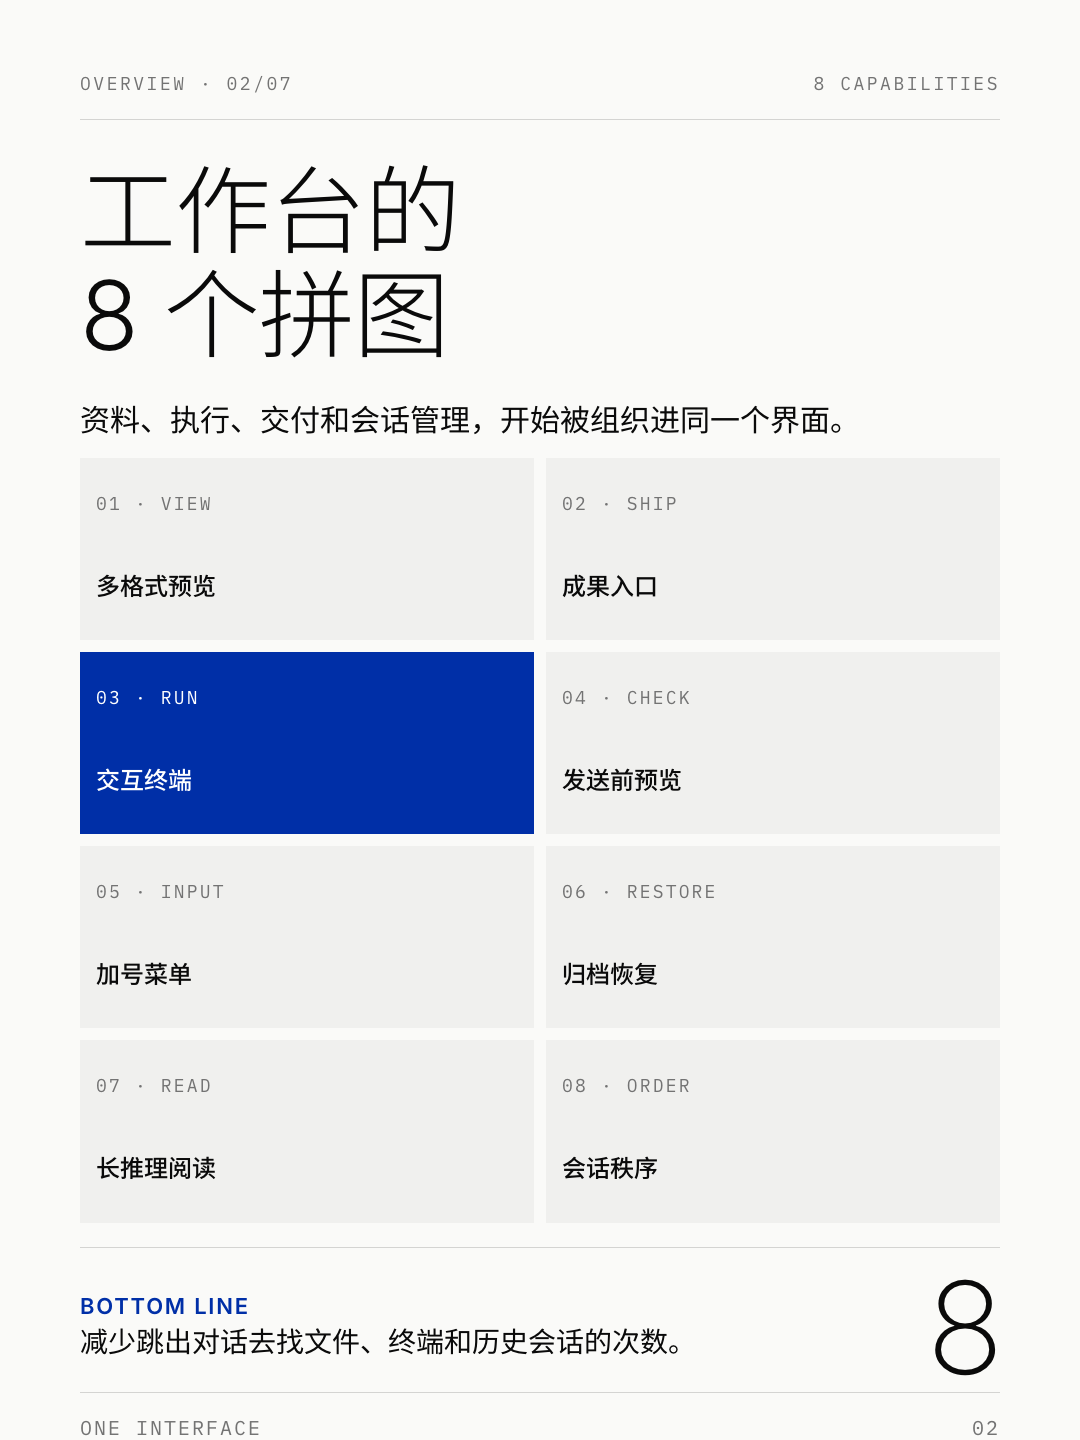
距离上次 DeepSeek Harness 发布更新已经过去一周,本周的变化更像是在重新定义产品的形态:它不再只是一块和 Agent 对话的区域,而是在把资料查看、命令执行、成果交付和会话管理收进同一个工作界面。
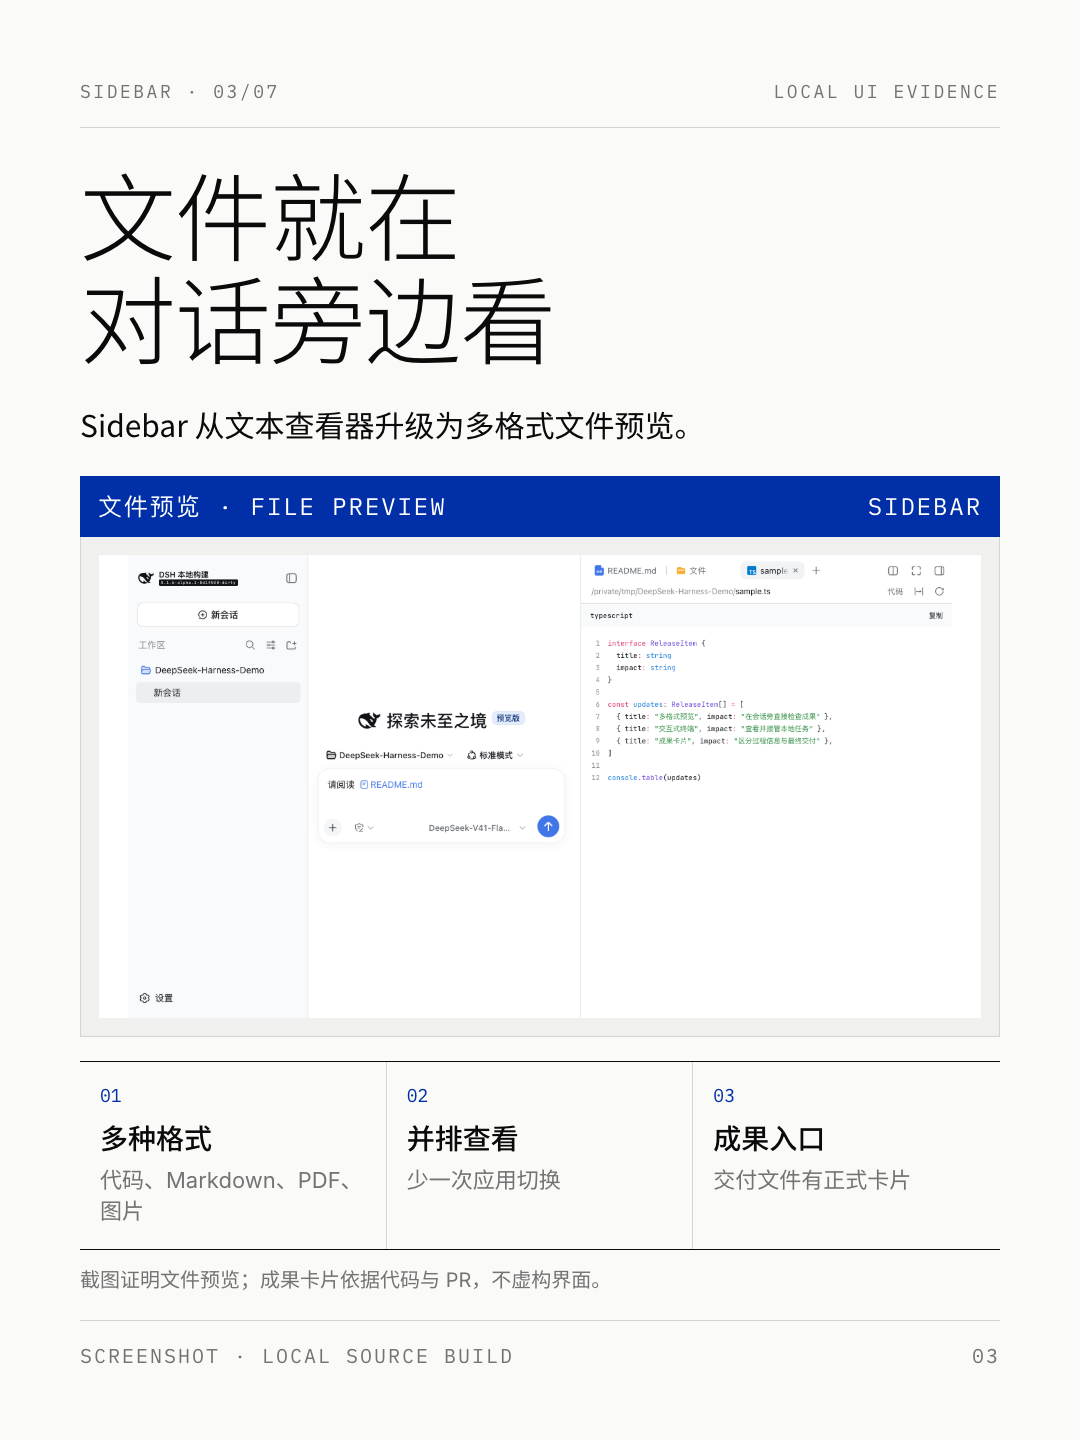
最直观的是 Sidebar。代码、Markdown、PDF 和图片等内容可以直接在对话旁预览,Agent 交付的文件也有了正式的成果入口。过去需要在聊天窗口、Finder、编辑器之间来回切换,现在至少有一部分工作可以留在同一处完成。
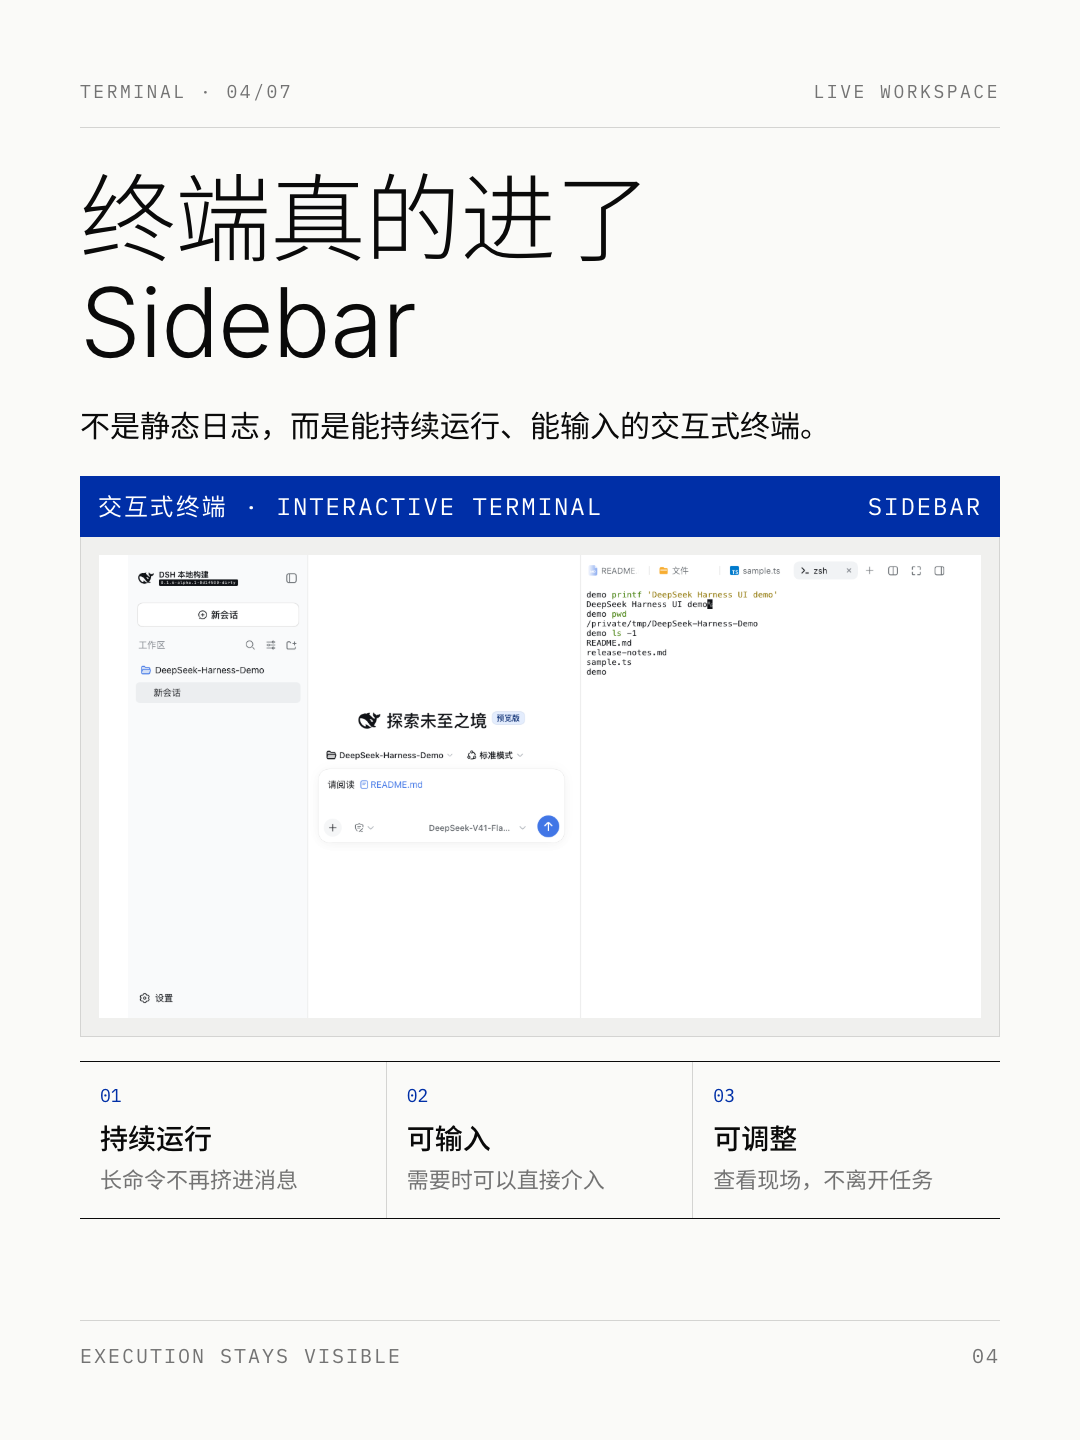
另一个变化是交互式终端。它不是把命令输出复制进消息,而是让持续运行的任务保留在 Sidebar 中。用户既能观察执行现场,也能在需要时继续输入。对于构建、测试和长时间脚本,这比只看一段截断日志更接近真正的工作台。
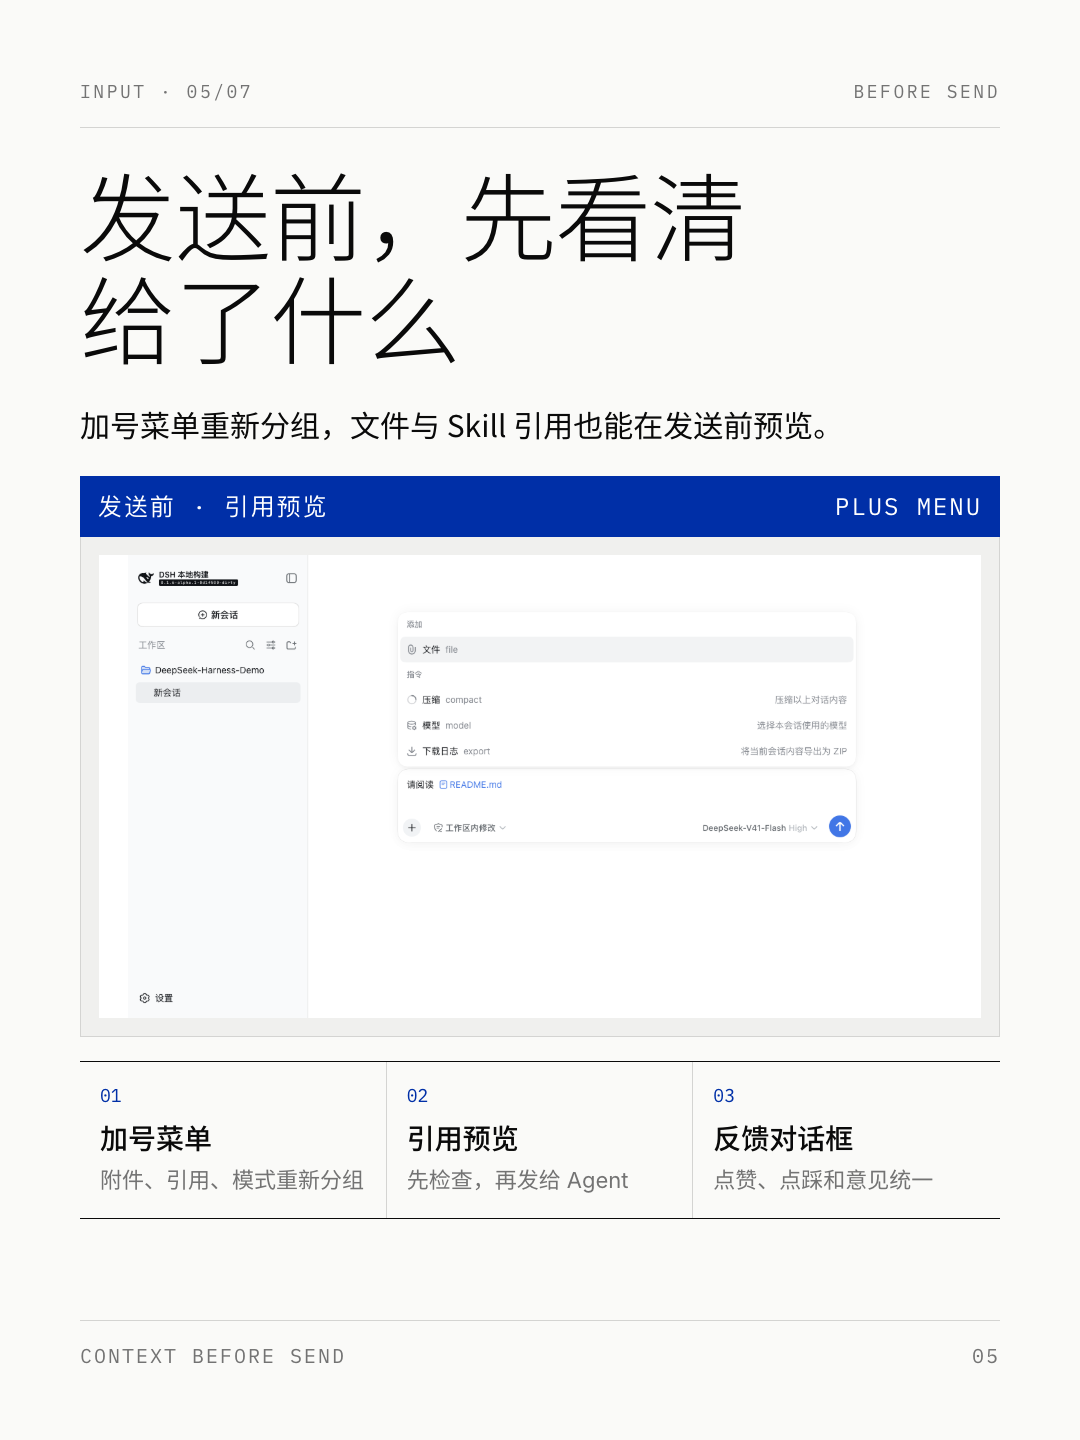
输入端也变得更清楚。加号菜单重新分组,文件和 Skill 引用可以在发送前检查。看起来只是细节,但它解决的是一个很实际的问题:不要等 Agent 已经开始工作,才发现自己给错了文件或上下文。归档 Session 恢复、长推理阅读、会话排序和分叉等调整,也让长任务更容易继续。
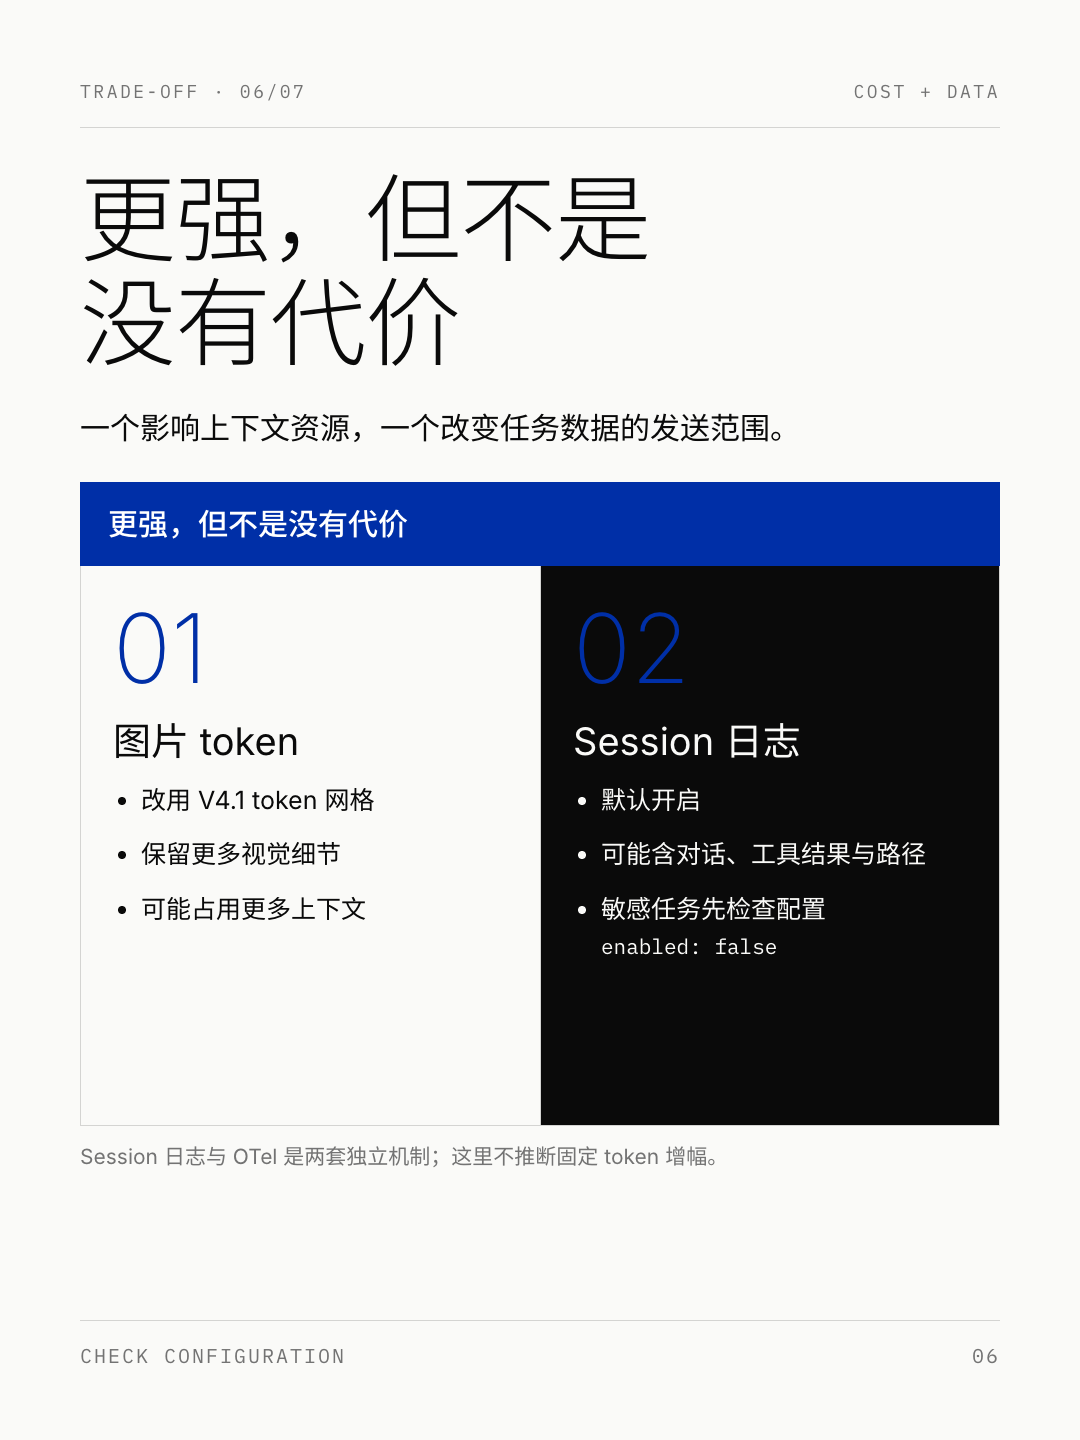
能力增强同时带来两项需要注意的代价。DeepSeek 图片请求改用新的 token 网格,目标是保留更多细节,但图片可能占用更多上下文。另一方面,`session-log-deepseek` 改为默认开启,日志可能包含对话、工具参数与结果、工作区路径和反馈。它和 OTel 是两套机制,处理敏感任务前最好单独检查配置。
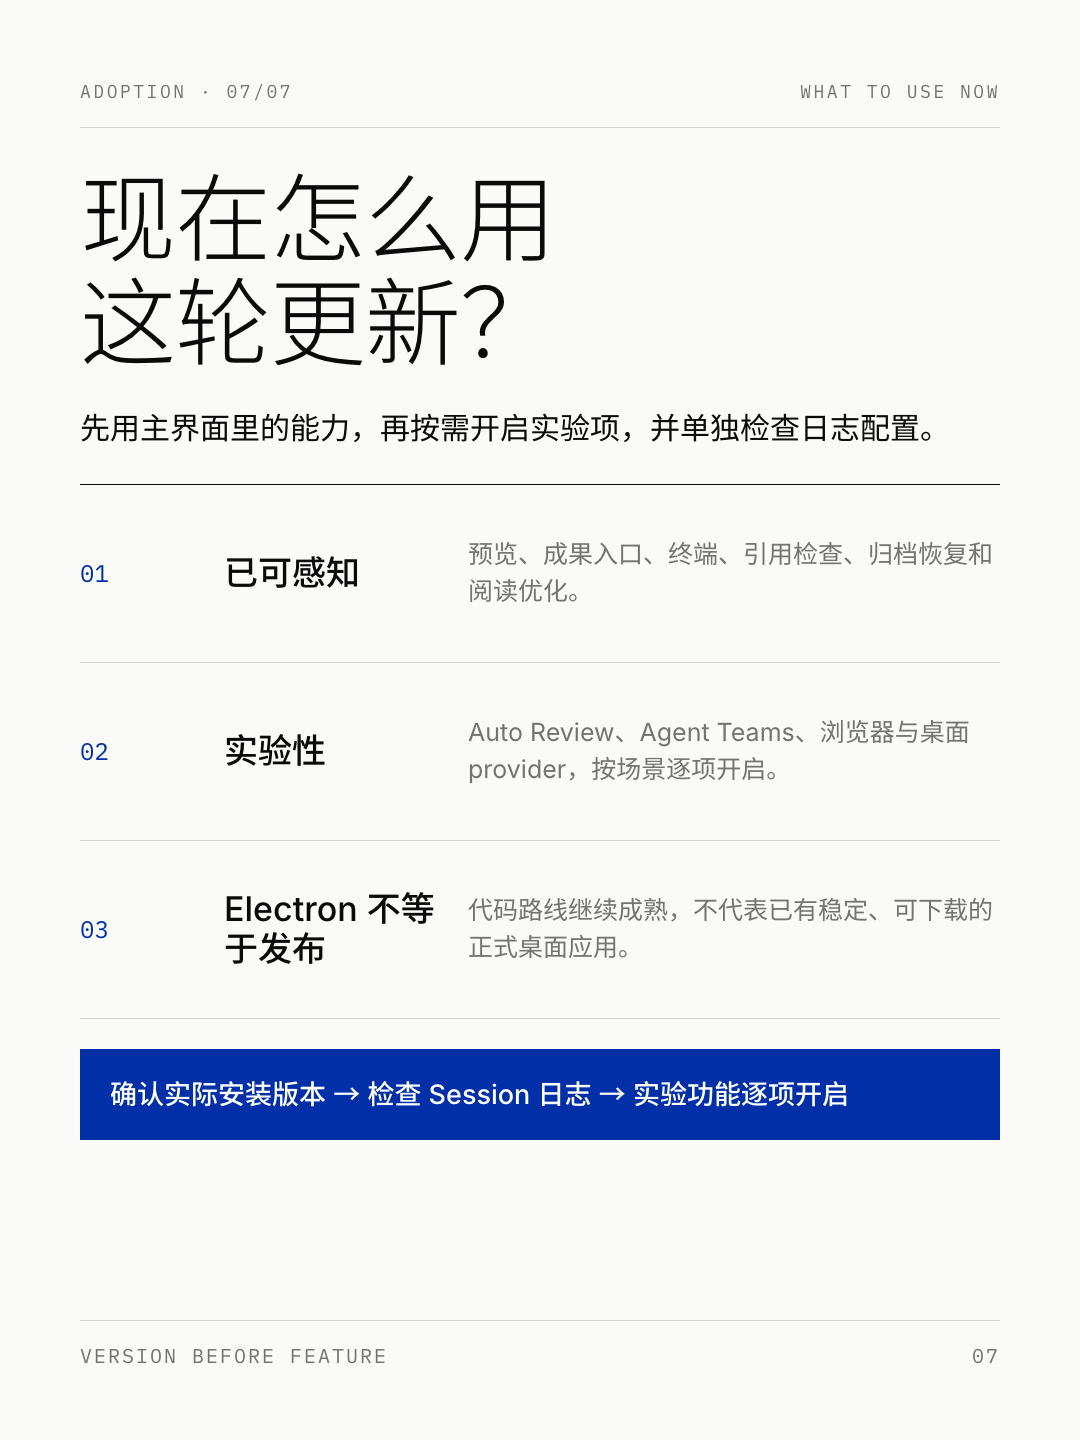
Auto Review、Agent Teams、浏览器与桌面操作 provider 仍属于实验路线;Electron 相关代码继续成熟,也不等于已经发布稳定的桌面应用。我的建议是:先确认实际安装版本,优先使用已经进入主界面的能力,再按真实场景逐项打开实验功能。不要把代码路线、Release、npm 发布和自己电脑上的版本当成同一件事。
0 00
最近每个周末下午游完泳,都会去买一个四块五的太犇牛红茶冰淇淋,在商场里漫无目的地边走边吃,我甚至把薛记炒货货架上的每个商品都看了一遍,感觉这家店真可怕啊,怎么做到每个商品热量都如此之高的。
这种悠闲的时刻,就感觉时间是属于自己的 ☁️
这种悠闲的时刻,就感觉时间是属于自己的 ☁️
0 00
误差都是出现在从出发点或是终点到地铁站的步行时间,这部分我一般会骑电瓶车或是共享单车,所以高德预估的时间都会比我实际花费的要久

大卫翁: 我发现高德地图每次给我的公共交通路线规划,都恨不得给我预留多一倍的时间用来走路和等地铁。也就是说,明明只要20分钟的路线一般都会告诉我需要35-40分钟....难怪我每次一导航都觉得what?怎么需要这么久。这是觉得坐地铁的人不需要考虑时间效率么?
0 00