即刻App年轻人的同好社区
下载
App内打开
怡燃
263关注174被关注0夸夸
Clear Thinking and Vibe Living.
置顶
怡燃
6年前
首先要对自己诚实。
20
怡燃
5天前
心理高度成熟的人是会穿社交外套的,这是好事。
00
怡燃
6天前
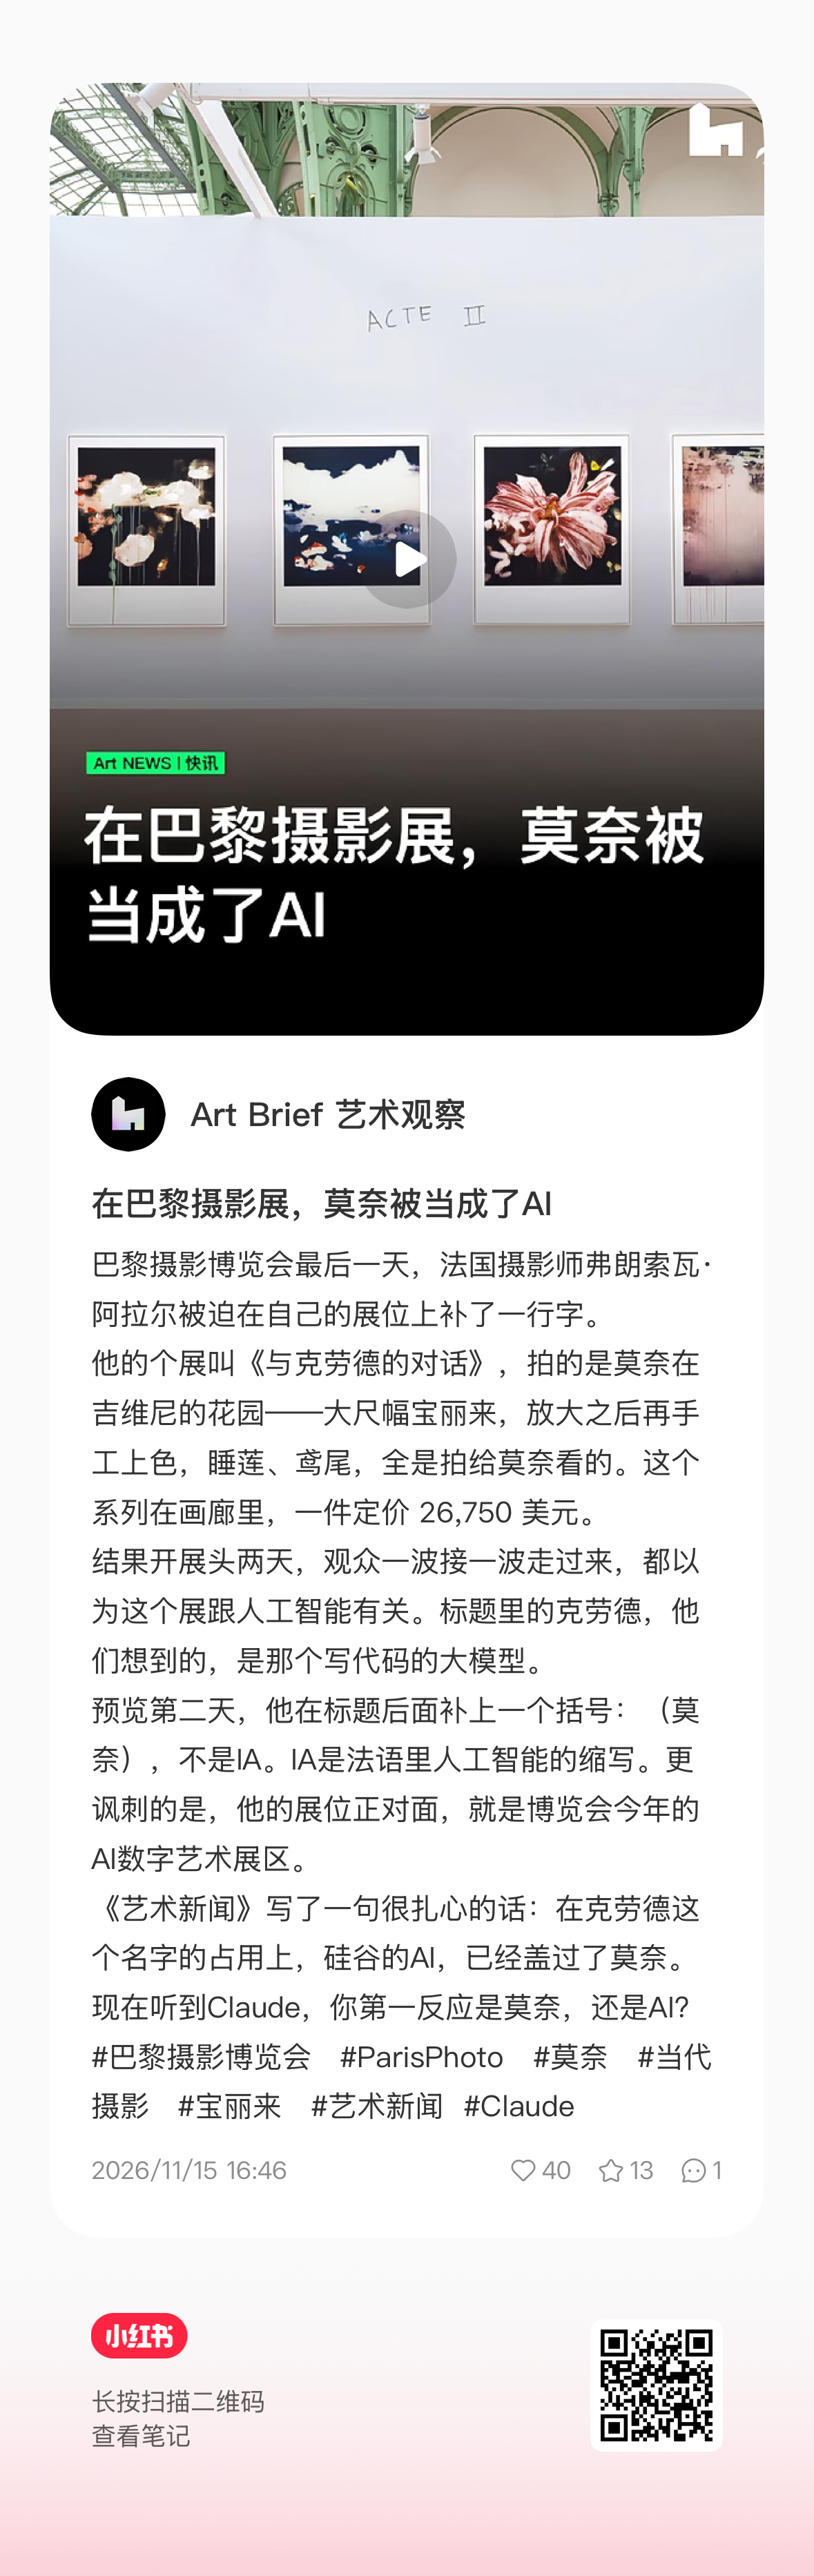
在巴黎摄影展,莫奈被当成了AI 巴黎摄影博览会最后一... xhslink.cn 复制后打开【小红书】App,笔记就在那里等你。
00
怡燃
12天前
恭喜这位幸运观众,一年一度代表即刻为您送上生日祝福的随机关注代表有图中几位。
祝你心中有期待,脚下有方向,
如月之恒,如日之升(◡‿◡✿)🌙☀️。
00
怡燃
13天前
在动态首页浏览不到的feed,倒是在发现-动态广场里刷到了😅......加上无法回顾点赞贴、转发维持在单链关系、评论无法收藏,即刻真得越来越古早味。
00
怡燃
13天前
文感力测试维度,阅读与写作。想到社媒表达其实在破坏这种写作能力,语境的丢失、防御性表达......都会让人越说越冗长,我自己已经是这样了🥲。

Puggo: 用「文感力」评测 agent 的写作水平 YouMind 内部原本有一套写作 benchmark,用来评测模型有没有覆盖写作要点、用对素材,结构、语气和篇幅是否符合要求。但随着模型不断变强,连 GPT-6 Luna 和 Opus 5.5 都打成了平手,但实际用起来,大家还是能感觉到不少差距。 我们观察用户在写作任务中使用的 prompt 发现,很多时候,用户传达的是一种感觉。比如:“让结尾带一点落空感。” 模型可能写成伤感。如果把评分标准写成“结尾要带有落空感”,再交给评委打分,伤感的结尾其实也能过关。 问题在于,把感觉写成评分标准,并没有让它变得更明确,只是把判断转交给了评委。最终测出来的,可能只是模型有多符合评委的口味。 那么怎样的写作算好?我们选择的角度是:好的写作从作者的意图出发,每一个选择都为这个意图服务。 写作很大程度上就是在做取舍:该交代哪个细节,哪句话不说出口,一个意思写到几分就停。而模型写作时是在替用户动笔,关键不是写出“一段合格的文字”,而是做出用户会做的选择。 所以我们衡量的是:在具体语境下,模型做出的取舍和成熟作者有多接近。这就像语文考试里的阅读理解:作者为什么选这个细节?为什么偏偏在这里结尾?我们把这种能力叫做「文感力」。 做法是:挑选知名作者近期发表、读者反响好的文章,挖掉其中一段,分析原文的写法为什么好,把每条理由写成一条标准,再针对每条标准改写原文,构造错误答案。这样只有原文能同时满足所有标准,答案是唯一的。 测试分阅读和写作两部分。阅读是从几个候选段落里选出原文。写作是把原文拆成零散素材,混入错误素材,再给一句故意写得模糊的要求,比如“这里想要一种安静的感觉”,让模型自己挑素材,把这一段写出来。 在这一指标下,Opus 5.5 拿下第一;Gemini 4 Argon 阅读最稳;Gemini 3.8 Flash 性价比最高。而在之前的评测里几乎没有差距的 Opus 5.5 和 GPT-6 Luna,在文感力上相差了 42 分。 还有几个有意思的发现: 所有模型写出来的段落都比原文长,中位长度是原文的 1.6 倍。面对一堆素材和一句模糊的要求,模型往往倾向于物尽其用,DeepSeek V4.1 Flash 和 Haiku 5.5 几乎是给什么用什么。 读得懂,不等于写得出。即使在模型每次都读对的文章上,仍有 58% 的补写至少破坏了一处作者的取舍。 当然,文感力只覆盖了写作质量的一部分。但它测出了“按需交付”这类评测所测不出的东西。模型如今都能较好地按要求交稿,很多时候也认得出好文,可轮到自己动笔时,差距依然明显,而这种差距,往往是用户最在意的。

00
怡燃
13天前
刷 vb,首页推来今何在的帖子,回复为何不愿参加最近很火的“再见友人”综艺。

我纳闷,怎么会推给我?再一看,仅粉丝可见。???我什么时候关注他的?

想了想,读书时谁没读过他的《悟空传》,虽然当时看得似懂非懂,但也算是熟悉的作者了,当然还有江南……

江湖是非多,写玄幻/武侠的作者,多少还是秉持着「相忘于江湖」的原则,知行合一了。
11
怡燃
17天前
清了相册腾出100G给iOS27,
AI 一出不想升了...
00