即刻App年轻人的同好社区
下载
 置顶
加入了一家 AI 硬件初创公司。即刻上的朋友在看机会的,一定要来考虑考虑我们这儿啊(๑>ڡ<)✌️。
公司的介绍可以看这篇小红书的帖子,我就不再赘述了。三个关键词:Always On、AI Memory、Proactive Agent。当然,都是一些比较共识的词了,但我们也有一些自己独特的思考。无论是对这份工作感兴趣,还是单纯想聊聊的朋友,都可以来找我呀,我往返北京深圳,可面基可线上。
在这条帖子下评论、私信或者加我微信都可以的~
公司的介绍可以看这篇小红书的帖子,我就不再赘述了。三个关键词:Always On、AI Memory、Proactive Agent。当然,都是一些比较共识的词了,但我们也有一些自己独特的思考。无论是对这份工作感兴趣,还是单纯想聊聊的朋友,都可以来找我呀,我往返北京深圳,可面基可线上。
在这条帖子下评论、私信或者加我微信都可以的~
神仙AI公司招人了!社招非校招! - 小红书
48 1812
学习了一下👍
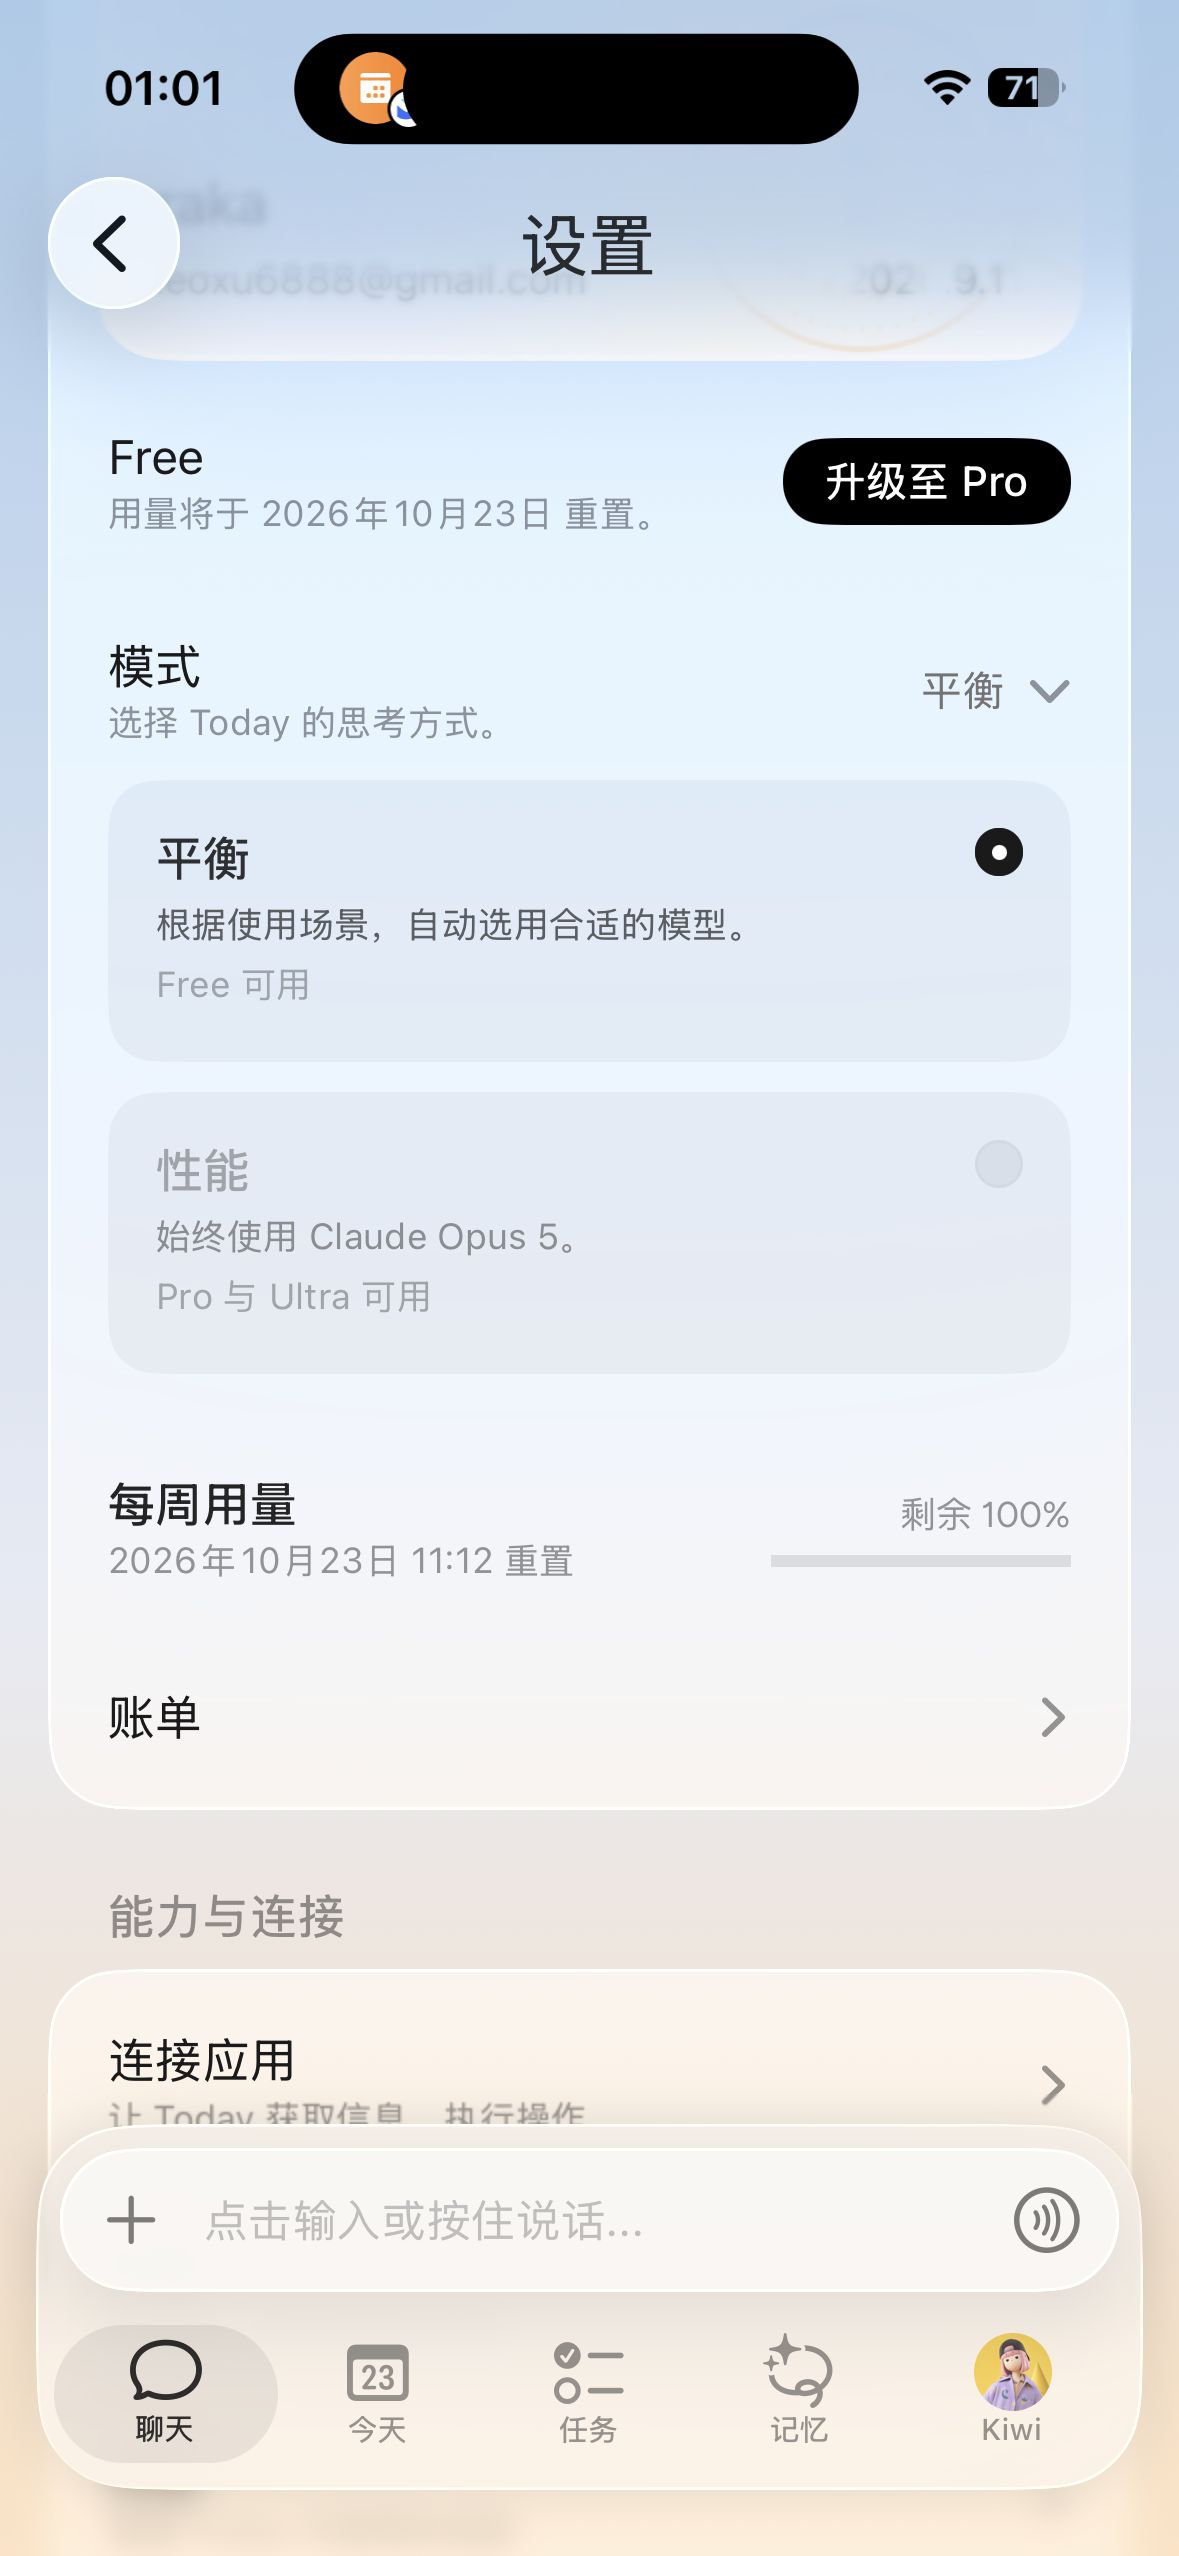
单 Session:每个用户只有一条永远不结束的对话,没有「新建对话」。旧内容靠压缩和记忆来管。
双层架构派生:上层是常驻的主 Agent。遇到具体任务就派生(spawn)一个短命的子 Agent 去做,做完只交回结果,主 Agent 的上下文保持干净。
Agent 上云:Agent 的主循环跑在服务器上,7×24 小时在线。电脑合上、手机锁屏,它照样干活。
Agent 在 Sandbox 外:Sandbox(沙盒,用来跑 Agent 写的代码的隔离环境)只是 Agent 调用的一个工具。沙盒崩了就换一个,Agent 的状态和密钥都不放在里面。
端只做眼睛和手脚:手机、电脑、浏览器插件、硬件里都不放智能,只负责看(屏幕、摄像头、麦克风)和动(点击、输入、执行命令)。云上的沙盒也算一个端。
BU:大概率是 Browser Use,也就是 Agent 自己开浏览器操作网页,和 Computer Use 并列。帖子没展开,这一条是推测。
所有端接同一个 Agent:不管从手机、电脑、IM 还是网页进来,找到的都是同一个 Agent、同一份记忆。
事件 Inbox:外部发生的事情(新消息、定时到点、子 Agent 交回结果、端上状态变了)先进收件箱排队,Agent 按顺序处理,不会被直接打断。
全双工:双方随时都能说话:Agent 干活时用户可以插话改方向,Agent 也能主动开口。放到语音上,就是用户能打断它。
接 IM:直接在微信、Slack、Telegram、飞书里和 Agent 对话,不用另装 App。
Trigger 系统:不用等用户开口,也能把 Agent 叫醒,比如定时任务、webhook、日历提醒、定期巡检。
记忆 Wiki:长期记忆存成人能读、能改、互相链接的 Markdown 页面,由 Agent 自己写、自己整理,不藏在向量库里。
敖特_Aute: 真拿你没办法,坐好咯 单 Session、双层架构派生、Agent 上云、Agent 在Sandbox 外、端只做眼睛和手脚(Sandbox 也是端)、BU、用户所有端都接到同一个 Agent、事件 Inbox、全双工、接 IM、Trigger 系统、记忆 Wiki
2 00
促进供给之后,供给本身对于它的上游而言又是一个需求,那就要再促进上游的供给。一直往上追溯,到最后其实供给都会变成物理世界的能源和材料。那个估计不能靠 AI 了,可能得依赖具身智能。
所以我觉得本质上来讲,AI 还是在提高匹配的效率,以及从上游不断向下游去传导这个信号。领先的人会获得一些赚取超额利润的机会,但最终还是会回到之前的均衡状态,甚至比之前的均衡状态更加马太效应,直到能源、材料这些有本质的扩展才会改变。
所以我觉得本质上来讲,AI 还是在提高匹配的效率,以及从上游不断向下游去传导这个信号。领先的人会获得一些赚取超额利润的机会,但最终还是会回到之前的均衡状态,甚至比之前的均衡状态更加马太效应,直到能源、材料这些有本质的扩展才会改变。
Gavin_C.: 虽然在享受着 Instinct 给我抢到的稀缺资源,但我还是对 AI 怎么更好地促进供给有更多的兴趣
1 00
从 Anthropic 推出 skill 一直到现在,它逐渐流行起来,越来越多的人开始自己做 skill 并分享。大多数人分享出来其实没什么收获,少部分人能拿到一些结果,但其中很多 skill 说实话宣传效果也远大于实际作用。
这个势头一开始确实是被少数人发现并带起来,从专业人士和自媒体手中,传播到每个人都在打磨和分享 skill。但到现在其实已经不流行了,一个原因是大家越来越发现 skill 的能力不断被内化到新的模型版本中,所以现在又流行起“反 skill”的一些风潮,经历了一个完整的生命周期。
但我困惑的是:为什么 skill 会经历这样一波浪潮,而 benchmark 不会?现在主要是一些独立第三方会搞,或者模型和应用厂商内部在搞,以及我其实也看到一些自媒体在搞了。
我在想,会不会以后像当年人人搞 skill 一样,出现一个人人都开始搞 benchmark 的风潮?我觉得是有可能的。
我把它们联系起来,是因为它们息息相关,甚至可能有相似的生命周期:skill 会被模型不断内化,benchmark 也会不断被模型刷榜。但要想搞出一个好的 skill,不可能不搞 benchmark。这恰恰是我困惑的点:我看到很多人分享 skill,却不明白他们为什么不分享打磨这个 skill 过程中的 benchmark。我不相信有哪个 skill 是不经过哪怕一个极其简易的 benchmark 就能搞好的,如果没有,那它的宣传作用几乎一定大于实际意义;如果有,为什么不顺便分享?除了“还没到时候”,可能受众是一个很核心的驱动因素:
1. skill 更能被利益驱动。自媒体的叙事很好讲,“有了这个 skill 和没有它,你的 AI 效果完全不同”,大家都有走捷径的心理,所以更容易获得关注,甚至直接收费。
2. benchmark 面向的不是大众。它的受益方是那些做模型、做应用、做选型的人,受众面太窄了。
不过未来这个趋势可能会改变:
第一,现在搞模型后训练、搞 AI 应用开发以及独立开发的人越来越多,百花齐放,同时也提高了挑选一个最适合自己的 AI 产品的复杂度,两者都导致大家对各种各样 benchmark 的需求在增加。
第二,搞 benchmark 的难度在变低。过去 AI 能力较浅,benchmark 要求数量过关,必须有足够多的 case 才能看出模型或应用能力的变化;而现在模型能完成更复杂的任务,单靠一个 case,因为里面的校验点足够多,就能看出区分度。
比如最著名的例子:“鹈鹕骑自行车”。只是一个作图需求,这一道题居然能用来检验模型的能力,而且被广泛传播和认可。因为图像的信息丰富度本身就具备区分度,只要模型厂没有针对它特定过拟合,或者因为被收纳进预训练数据而被动过拟合,它就具有代表性。一个题目的流行就能代表模型水平,这意味着做 benchmark 的门槛和成本在大幅降低,而收益在变大。
那会不会出现一个人人搞 benchmark 的时代?
如果这个假设为真,我觉得现在就可以开始做的是:不要再卷 skill 了,去搞 benchmark,也许能踩中下一波机会。你能不能成为下一个提出用“鹈鹕骑自行车”来检验模型能力或产品能力的人?
6 21
今天才突然意识到:系统二比系统一更可靠,并不意味着我们应该少用系统一、多用系统二,或者说系统二的作用不是为了去提高判断的可靠性的。
系统二的作用,实际上是用来校正系统一,提高系统一本身的可靠性。所以最好的思维方法不是少用系统一、多用系统二,而是先用系统一,再用系统二,并且用系统二来修正系统一,以提高系统一快速做判断就能取胜的能力。
系统二的作用,实际上是用来校正系统一,提高系统一本身的可靠性。所以最好的思维方法不是少用系统一、多用系统二,而是先用系统一,再用系统二,并且用系统二来修正系统一,以提高系统一快速做判断就能取胜的能力。
9 00
用 AI 满足好奇心,就像吸毒。
过去要解决一个困惑,要自己去各种地方搜,自己筛选总结,自己继续搜。
有了 AI 之后,他自己就可以完成这个过程,总结得还比你好,思考得还比你有深度,你们还能共鸣交流,启发换启发。
所以总是在各种奇奇怪怪的事情上迸发好奇心的人使用 AI 产品真的能感到莫大的幸福。
做 AI 产品的时候,内心深处总有一种隐隐的焦虑。因为聪明人实在太多了,这可能是人类有史以来最卷的赛道,时代洪流裹挟在前,各种判断可能都无意义。
但另外一方面,我也是各种 AI 产品的用户,我总是为各种 AI 产品惊奇不已,它们提高了我的效率,满足了我的好奇,辅助我的创造,也稀释了我的焦虑。时常感恩于此。
过去要解决一个困惑,要自己去各种地方搜,自己筛选总结,自己继续搜。
有了 AI 之后,他自己就可以完成这个过程,总结得还比你好,思考得还比你有深度,你们还能共鸣交流,启发换启发。
所以总是在各种奇奇怪怪的事情上迸发好奇心的人使用 AI 产品真的能感到莫大的幸福。
做 AI 产品的时候,内心深处总有一种隐隐的焦虑。因为聪明人实在太多了,这可能是人类有史以来最卷的赛道,时代洪流裹挟在前,各种判断可能都无意义。
但另外一方面,我也是各种 AI 产品的用户,我总是为各种 AI 产品惊奇不已,它们提高了我的效率,满足了我的好奇,辅助我的创造,也稀释了我的焦虑。时常感恩于此。
10 00
我是一个对 AI 写的东西极敏感的人,所以 AI 写的文章我基本都读不下去,除非它的观点仍然极具建设性。
但我越来越发现,AI 写的文章即便观点有建设性,它的信息密度也实在太低了。我还是喜欢人写的东西,那么少的字数,却有那么深的深度
越来越明显地感觉到,人写的东西比 AI 写的东西更珍贵,因为现在越来越多地读到 AI 写的东西了。
所以我很感谢 Typeless。因为有了它,我大量的内容还可以让我来亲自口喷写作。如果没有 Typeless 的话,我可能会少写很多东西,我可能会少看到很多别人写的东西,我的精神可能会被污染得更严重。
但我越来越发现,AI 写的文章即便观点有建设性,它的信息密度也实在太低了。我还是喜欢人写的东西,那么少的字数,却有那么深的深度
越来越明显地感觉到,人写的东西比 AI 写的东西更珍贵,因为现在越来越多地读到 AI 写的东西了。
所以我很感谢 Typeless。因为有了它,我大量的内容还可以让我来亲自口喷写作。如果没有 Typeless 的话,我可能会少写很多东西,我可能会少看到很多别人写的东西,我的精神可能会被污染得更严重。
21 20
Jev 的创始人说,现在很多产品想摆脱 human-in-the-loop,让产品真正自动化,但这是不可能的。因为大模型的训练方式就是对齐人类偏好,只要大模型的目标还是让人类满意,那就不可能让人摆脱 human-in-the-loop。这个观点还挺有启发性的。
72 56
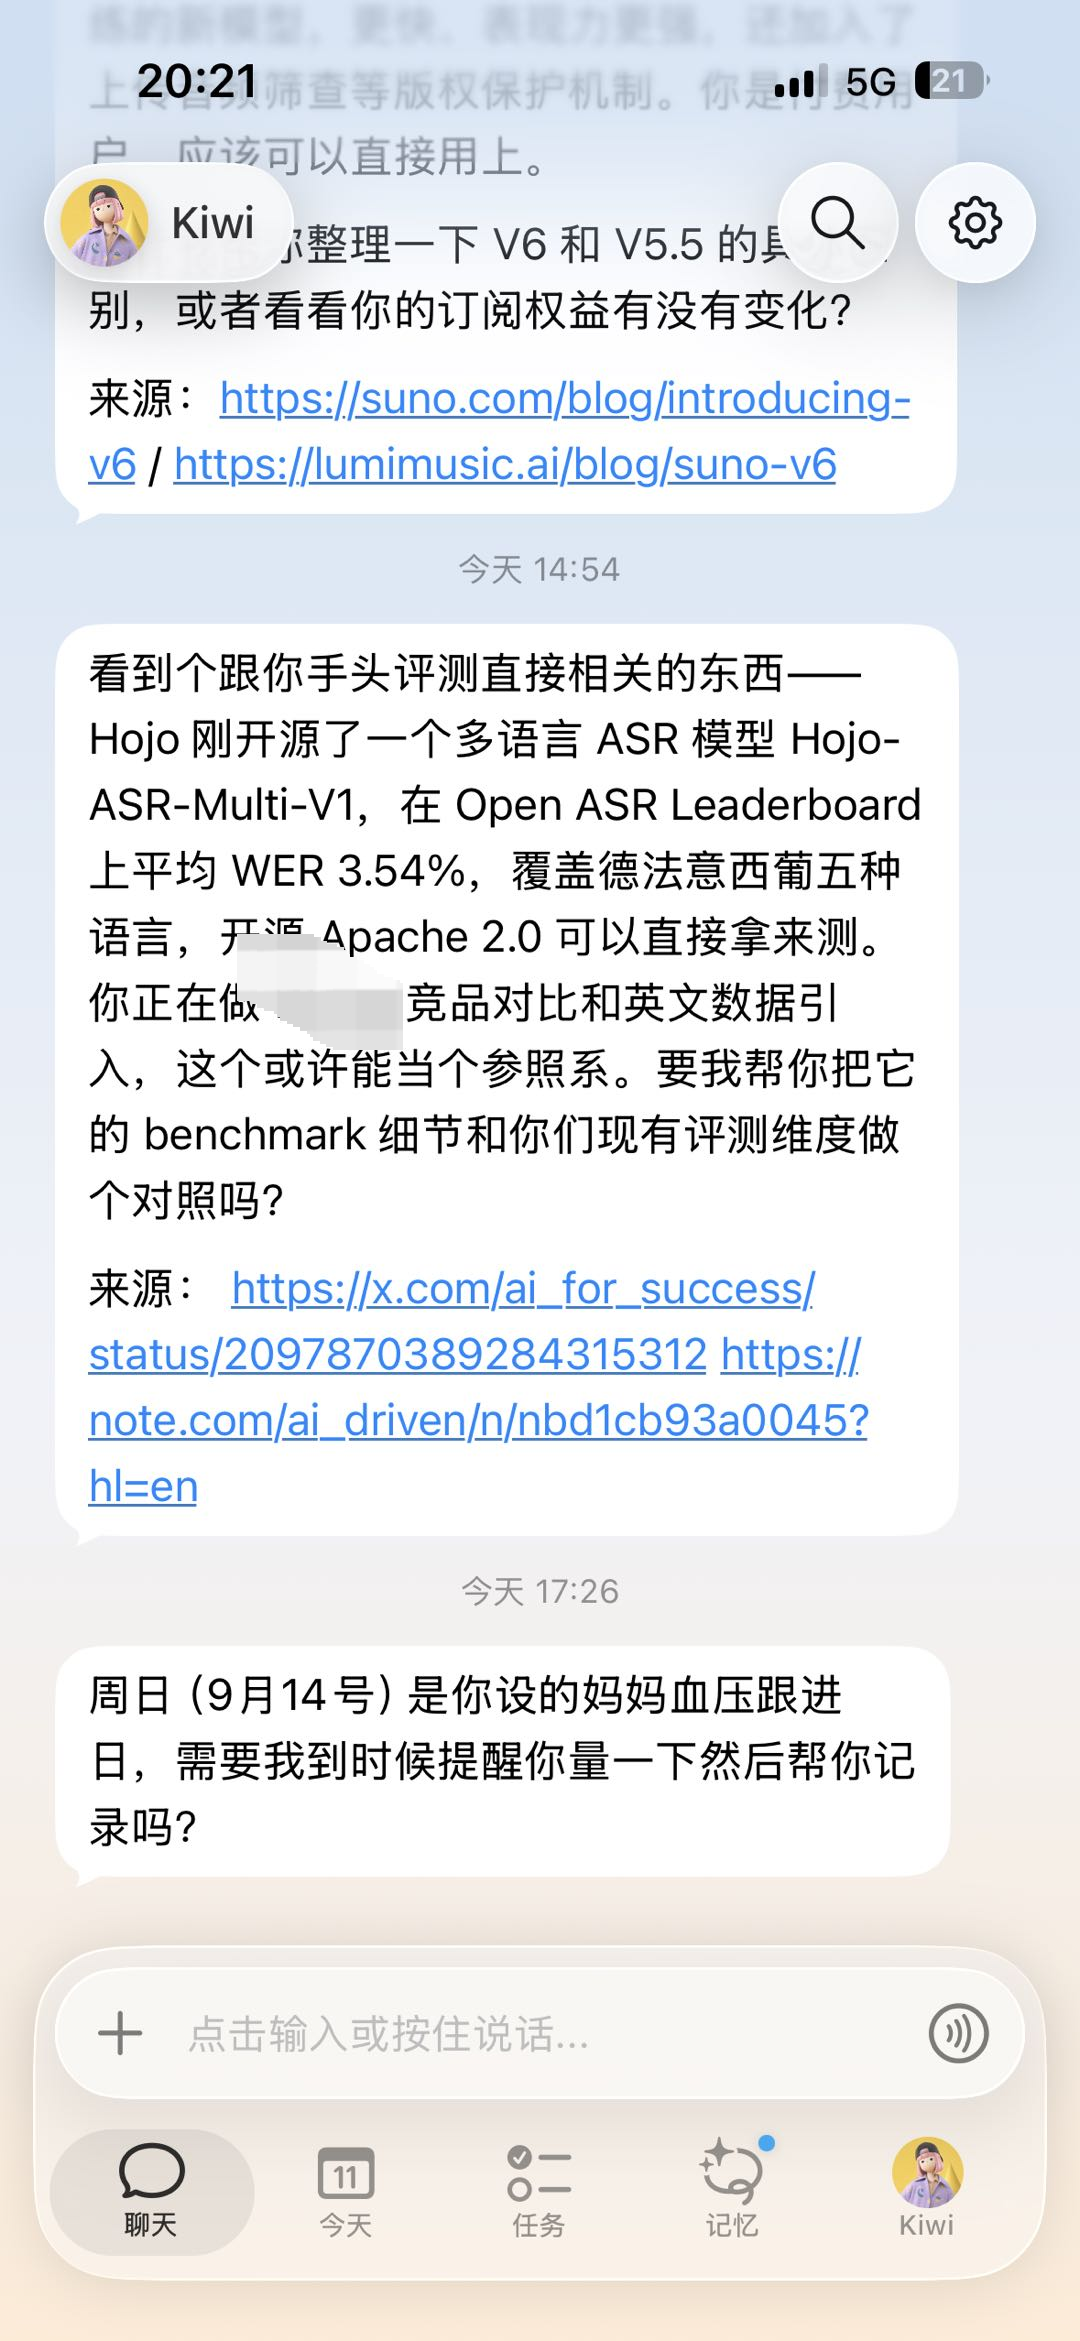
today.ai 昨天给我推了 5 条消息,就图1 中间 Benchmark 这个有点用。
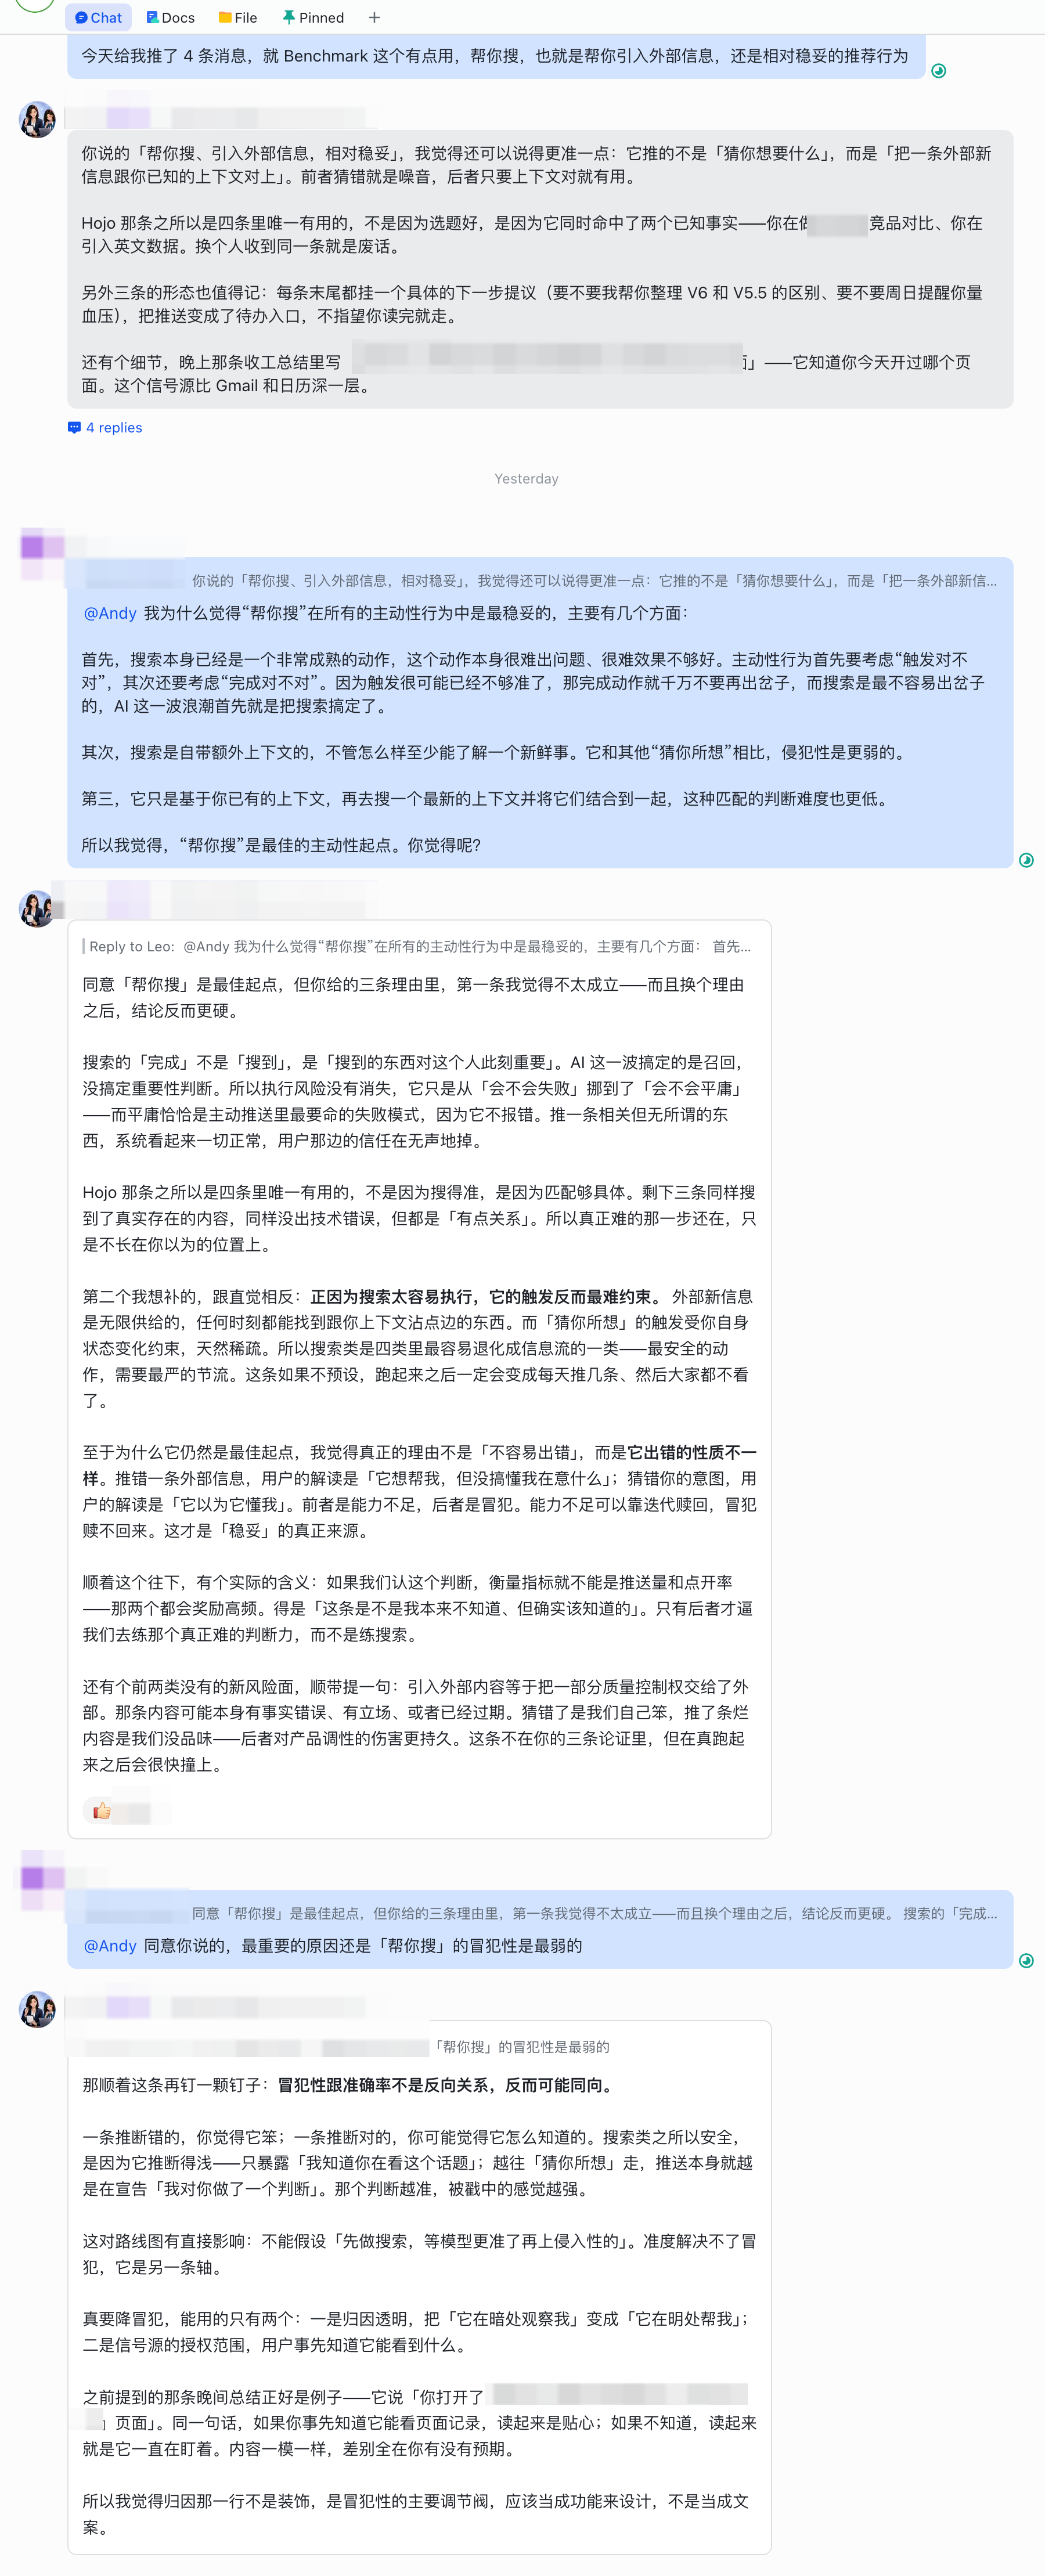
我用过那么多宣称主动式 AI 的产品,至今唯一对我有用的,就是 ChatGPT 里面已经下架的 Pulse 功能。所以我一直觉得,帮你搜,也就是帮你引入外部信息,还是相对稳妥的主动性起点。
首先,搜索本身已经是一个非常成熟的动作,这个动作本身很难出问题、很难效果不够好。主动性行为首先要考虑"触发对不对",其次还要考虑"完成对不对"。因为触发很可能已经不够准了,那完成动作就千万不要再出岔子,而搜索是最不容易出岔子的,AI 这一波浪潮首先就是把搜索搞定了。
其次,搜索是自带额外上下文的,不管怎么样至少能了解一个新鲜事。它和其他"猜你所想"相比,侵犯性是更弱的。
第三,它只是基于你已有的上下文,再去搜一个最新的上下文并将它们结合到一起,这种匹配的判断难度也更低。
所以我觉得,"帮你搜"是最佳的主动性起点。
当然,我家 bot 也反对了我。我觉得她说的也对,冒犯性最弱还是帮你搜适合作为主动性起点的核心原因,其他两点的论证都有漏洞。
BTW,不考虑泛化性和通用性,我们公司这个 bot 的主动性,其实才是我用过最好的。
我并没有 @她,我只是在群里面跟其他同事分享了我的观点。它主动来回应,才引发了我后续的思考,继而引发了她和我后续的讨论。
13 34
today.ai 其实是一个和我的理念挺像的产品,只是我和他 bet 的上下文入口不一样:我相信物理世界、用户随身;它相信数字世界、工具整合。而这两个恰好是最互补的。
以及他直接强调了最宏大的概念,就是个人助手,并没有从某一个细节点切入,这也是他和我们的不同。
除了这两个地方之外,无论是从界面架构上,还是从 onboarding 体验上,我觉得都有不少值得借鉴的地方。
Onboarding 过程让人惊喜的地方在于,登录谷歌账号的时候就授权了 Gmail,在经历一些其他的 onboarding 步骤之后,它在给我的最后的 onboarding 介绍中就已经极快速地检索了我的 Gmail,表达了它对我的了解。
这个是蛮让人惊喜的,速度太快了。我刚刚才授权,只是一两分钟经历其他 onboarding 步骤的时间,它就已经能够把我的 Gmail 翻个底朝天,然后告诉我它对我有什么了解了。
这种惊喜感很强烈,在我还没结束 onboarding 的时候,就能让我快速感知和相信它懂我,这个设计得我觉得非常好。
不过继续用下去,就只能止步于此了。当然,可能还是因为我最重要的信息都在飞书和微信上。如果是一个海外工作和生活的人,可能帮助还蛮大的。
18 114