即刻App年轻人的同好社区
下载
 置顶
论文:arxiv.org
Why is AI-generated language so hard to understand?
-----------------------
AI 生成的文本为什么越来越难读?
研究者提出了一个统一的解释。
人类语言经过长期演化,被优化来成功沟通。这意味着什么?一个人说话时会倾向于缩短依存距离、在关键位置插入信号词、避免罕见搭配,这些习惯降低了听者的理解负担。心理语言学把这种倾向叫做“均匀信息密度”(uniform information density):说话人把信息分散开,避免在某一点突然堆积太多信息让听者处理不过来。
但现在的前沿模型不再只是模仿人类文本。它们经历了大量后训练,用强化学习去解数学题、写代码、做推理。在这些任务里,一个模型因为答对了会获得奖励,但因为表达清楚不会获得任何额外的奖励。同时上下文窗口有限制,用更少的词说同样的事就能在有限空间里装更多信息。这两个因素合在一起,制造了一种信息密度压力:模型倾向于选择更短更密集的表达方式,即使这意味着偏离人类的语言习惯。
基于这篇论文的研究,可以在 Agents.md 中添加如下要求,尝试提升文本可读性:
1. 句间连接不许省。 两个判断挨着放时,如果第二句不是对第一句的直接延续,中间必须有一句话交代它们的关系。读者不应该需要自己猜两句话之间是转折、因果、还是补充。问题和回答之间同理:问题出现后,至少停一句话再展开回应。
2. 修饰语不超过两层。 一个名词前面的定语不超过两层嵌套。需要三层以上时,先把最内层的概念用一句话说清楚,再往外套。「用户行为数据分析模型优化方案」这类写法禁止出现。
3. 同一段内,抽象概念做主语并搭配动作动词的句子不超过两句。 「这个框架吞噬了…」「这条规则抓住了…」「这个机制驱动了…」——每一句单独看没问题,密集出现时读者的理解负担会累积。第三句起必须换成具体的人、事物或场景做主语。
4. 写完后自检搭配。 逐句检查名词与动词的搭配,问:这个搭配在日常口语里说不说?如果说不出来,换成说得出来的。每个字都认识但连在一起别扭的表述,就是需要换的。
50 315
辅导孩子学习诗词 Prompt:
---------------------
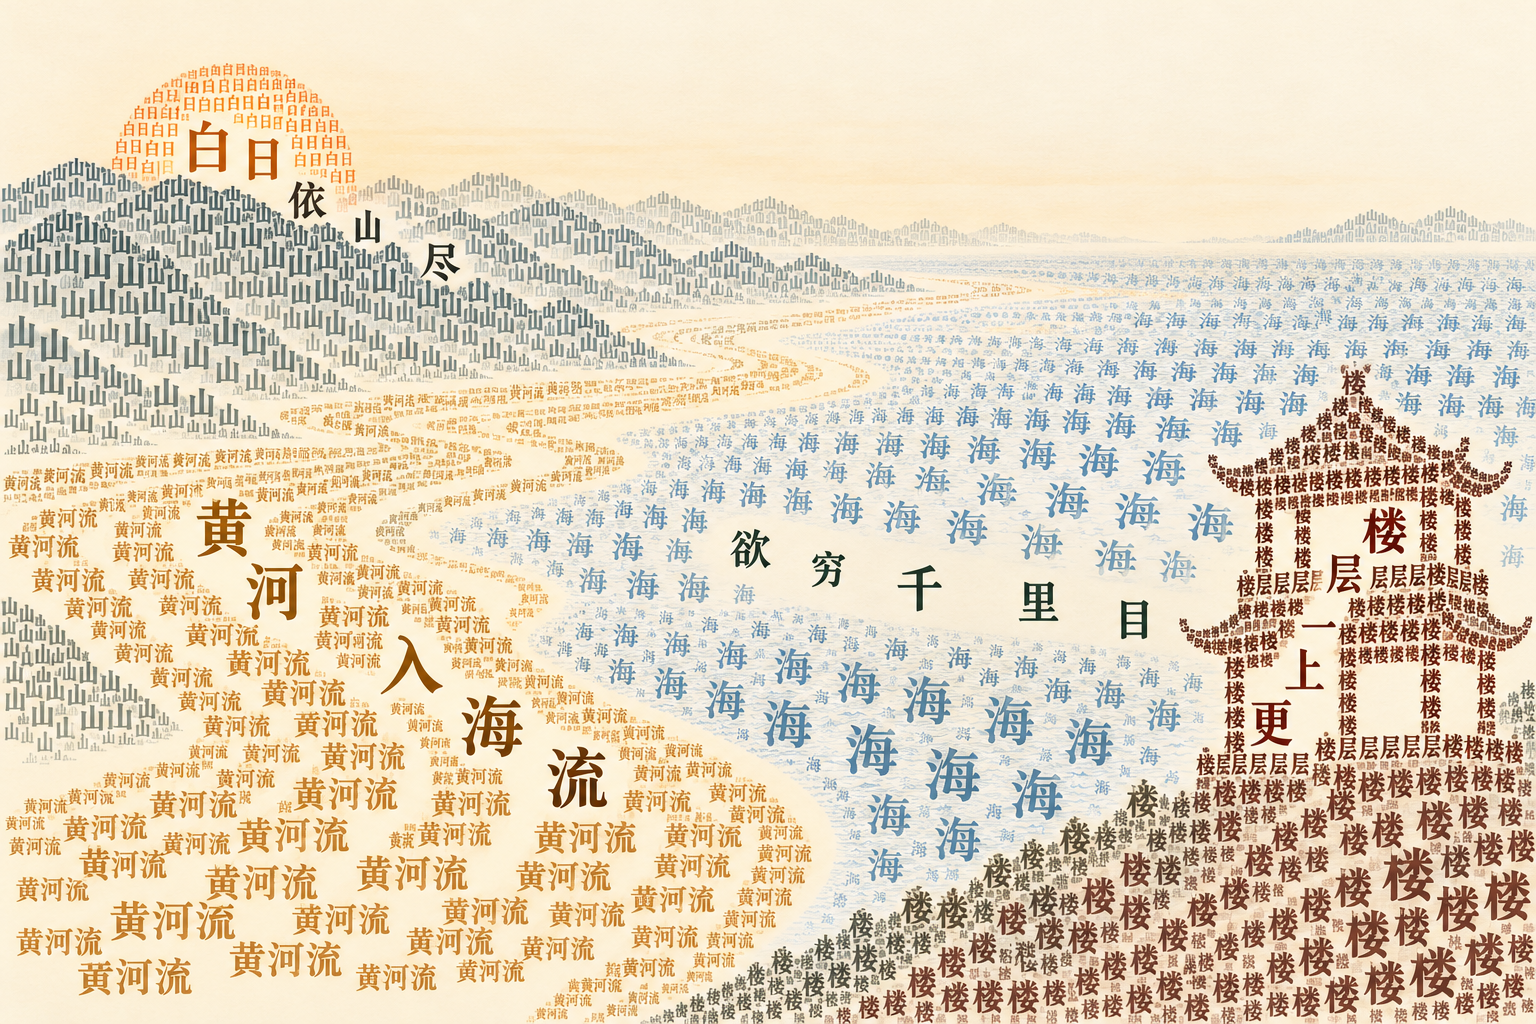
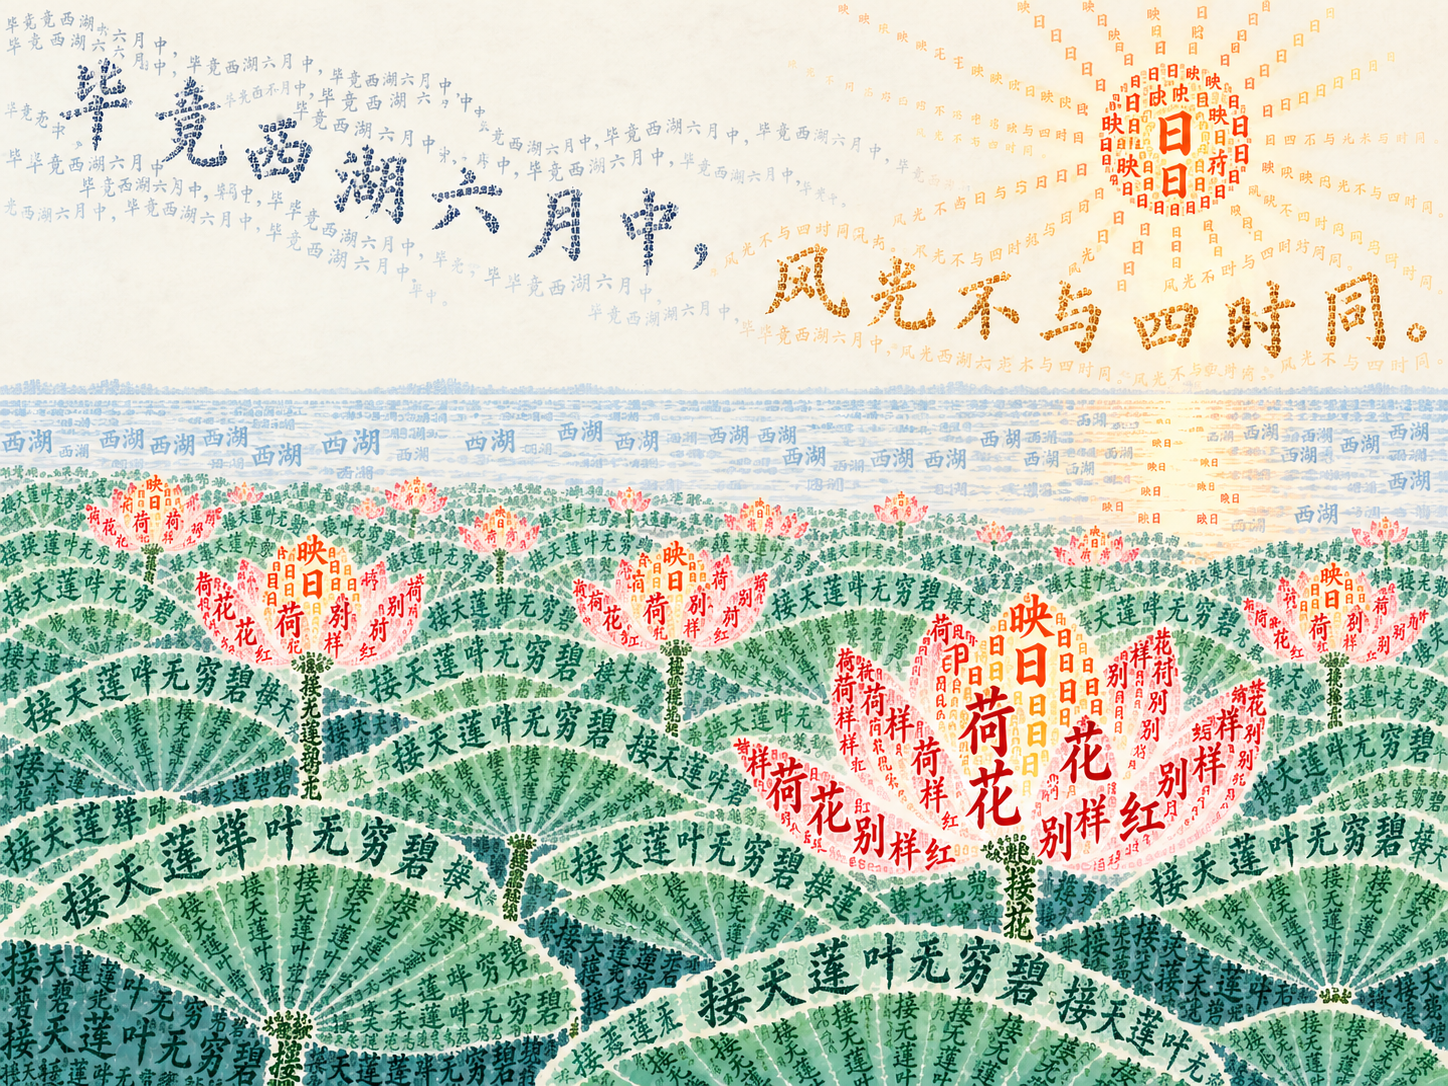
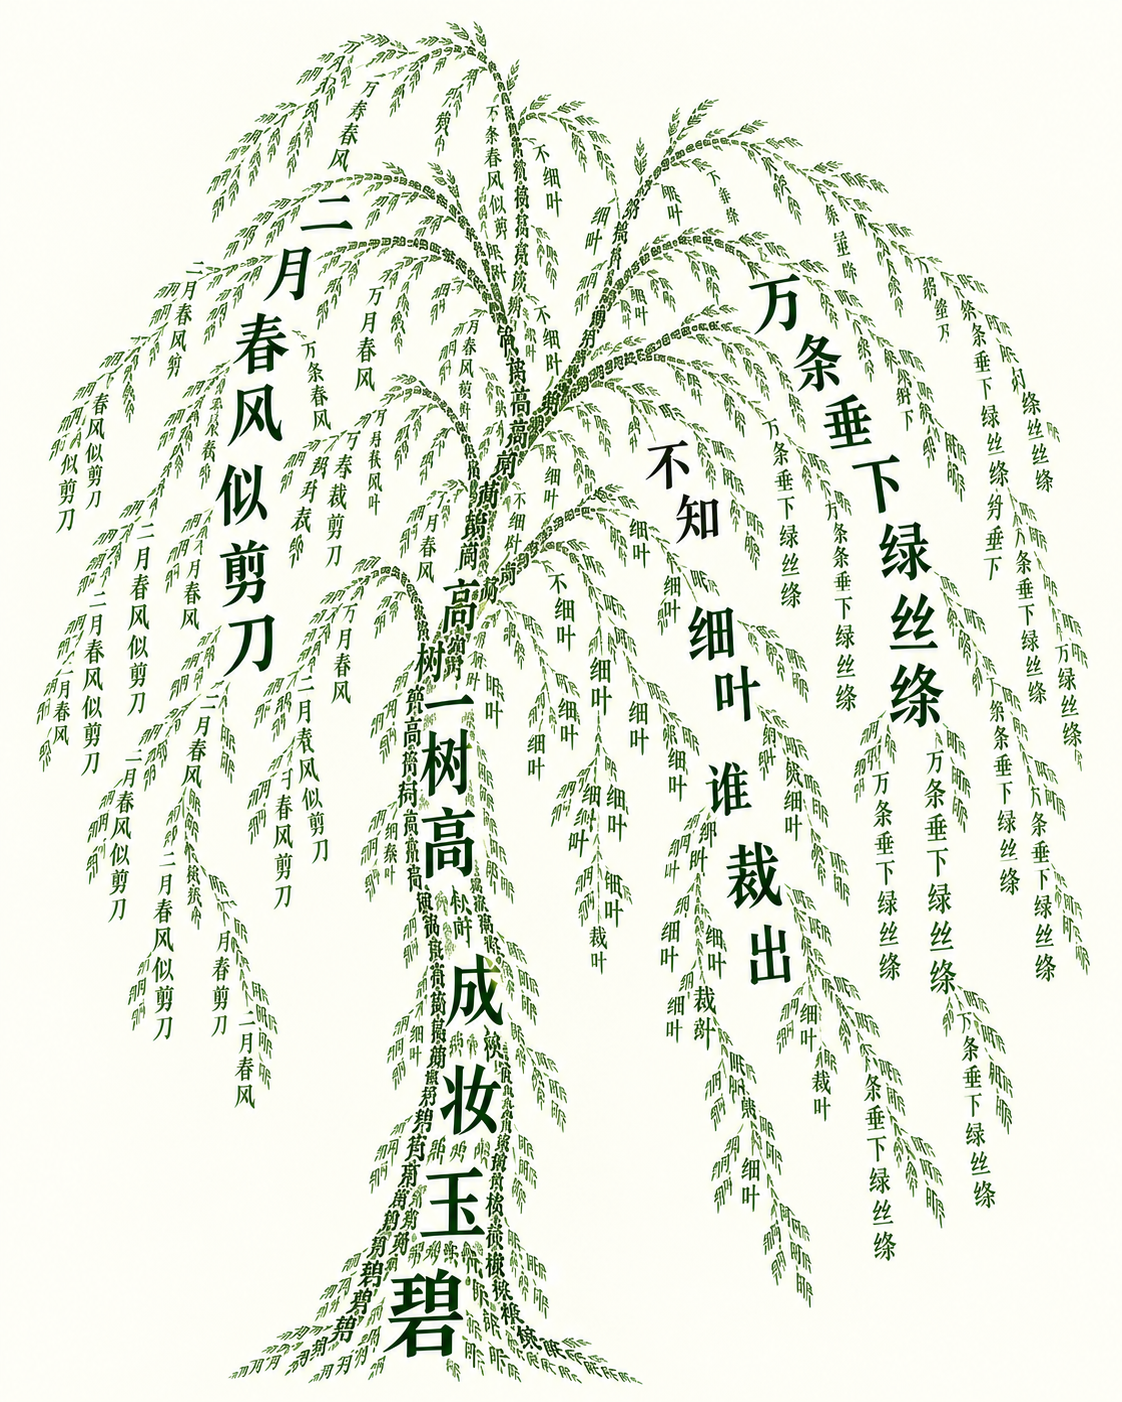
你要把一首诗变成一幅只由诗中文字组成的图。字的位置和走向就是画面本身:读者既能看出画面,也能顺着一条路径把整首诗读下来。
第一步,找事实。读诗,写出画面里有哪些东西,以及它们之间的关系:谁在上,谁垂下,谁在动,往哪个方向动。只写诗里有的,不添加。
第二步,定投影。
- 每个东西由诗里指称它、或者描写它的那些字构成。
- 关系换成空间关系:垂下就让字沿弧线往下排,高就让字竖着往上叠,风就让字斜着横穿画面。
- 表示疑问、否定、比喻的字(如"不知""谁""似")不对应任何东西,放在空白处或两个意象的交界处,用位置显示它们的作用。
第三步,排出来。输出一张图片,元素是文字,呈现这个意向
第四步,对照检查。逐条核对,有一条不满足就改,直到全部满足:
1. 图中所有字都出自原诗。为了让画面饱满,可以重复使用诗里的字。
2. 不看原诗的人能认出这是什么画面。
3. 按阅读路径能把原诗一字不差读下来。
4. 每个意象都由指称它的字构成,不拿别的字凑。
诗:{在这里放诗}
160 1467

每个季度给自己设定一个思考问题。
这个季度问题会像一个“吸引子”一样,将零散的信息和事件围绕它打转,碰撞、酝酿,大脑中可能会突然出现“火花”。
一年想清楚四个问题,慢一点,再慢一点。
这个季度问题会像一个“吸引子”一样,将零散的信息和事件围绕它打转,碰撞、酝酿,大脑中可能会突然出现“火花”。
一年想清楚四个问题,慢一点,再慢一点。
57 15
推荐一篇论文:arxiv.org
论文中针对阅读提出了一个非常有意思的取景框架。
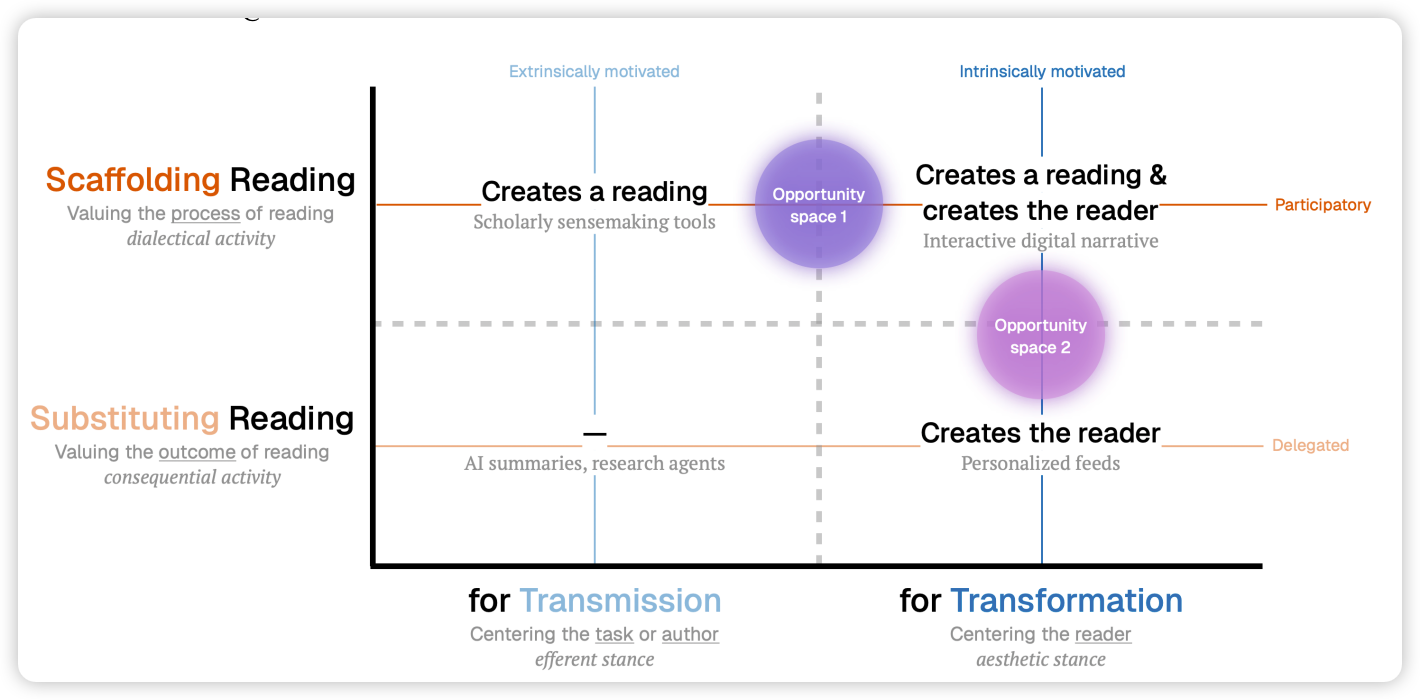
我们一直有「六经注我」 vs 「我注六经」的分类,可以理解为「以读者为中心」 vs 「以作者为中心」。
现在有了 AI,会带来什么变化?
这论文加了一个维度:「AI 替我读」vs「AI 陪我读」。
两者一结合,就出现了四象限。可以把当下的 AI 工具和应用场景放置其中进行分析。
针对「AI 陪我读」这个有意思的话题,又给了三个工具:
第一类是跑鞋型。跑鞋不改变你跑步的方式,它减少脚和地面之间的摩擦,让你跑同样的路更省力。对应到阅读,就是让你用同样的方式读,但读得更顺。术语弹窗让你不必中断去查词典,高亮系统替你标出哪些段落值得细读、哪些可以略过,自动排版让长文档更容易扫视。你还是在读,读的动作没有变,只是路面变平了。
第二类是哑铃型。哑铃的作用不是让你省力,恰恰相反,它故意给你加负重,目的是让你变强。对应到阅读,就是在阅读过程中设置有益的阻力。比如读完一段之后要求你用自己的话复述,再往下翻之前先让你预测作者接下来会说什么,或者定期抛出问题检验你是否真的理解了而不只是眼睛扫过去了。这些动作会让阅读变慢,但慢下来的那部分恰好是理解发生的地方。
第三类是滑雪板型。滑雪板不是让你走路更快,也不是让你腿更有力,它让你做到一件走路根本做不到的事——在雪上滑行。对应到阅读,就是让你和文本之间产生以前不可能的交互方式。把一篇论文的段落拖到二维空间里重新排列,让两篇论文的论证链条并排对照,在阅读痕迹上回溯自己三个月前读同一篇时关注了什么、现在关注了什么。这些不是「读得更快」或「理解得更深」,而是一种全新的阅读动作。
有了这个框架,就像是拥有了一张地图。针对自己的需求,可以在对应的象限中寻找解法。
80 215
19 111