即刻App年轻人的同好社区
下载
 置顶
🤖一点自我介绍
➕AI玩家
➕PikaAI/FlovaAI超创
➕可灵AI优创
▪️商业信息系统专业
▪️有两个硕士学位
▪️在美国待过六年
▪️目前base上海
▪️就职于世界最大的企业管理软件公司SAP
▪️基于个人兴趣和职业要求研究AI
🎨一些AIGC作品
🔶MIT Season 4入围和提名《Red》xhslink.com
🔶思维实验《The Last Day》b23.tv
🔸《春江花月夜》b23.tv
🔸AI电影短片《流浪地球2人物小传:时光的回响 2.0》b23.tv
🔸可灵AI 2.0模型短片大赛一等奖《FLY》b23.tv
🔸教你如何在三次元施展魔法《Magic in Your Hand》b23.tv
🔸暗黑美学《降临》b23.tv
🔸AI为眼《Alive》b23.tv
🔸电影频道“AI影像人才优选计划”入围短片《榫卯结构·AI全息》:xhslink.com
🔸全AI高级珠宝广告《宝石如星,蝶梦似幻》:xhslink.com
🔸中国美术学院“一万道彩虹”获奖AI短片《Draw A Colorful World》:xhslink.com
🔸中国美术学院“时空博物馆”AIGC数字艺术大赛获奖AI短片《翼马飞翔》:b23.tv
🔸AI电影短片《流浪地球2人物小传:时光的回响》:b23.tv
📝关于AI写的一些文章
🔹《论AI视频Skill的开发》mp.weixin.qq.com
🔹《诗意与AI创作》mp.weixin.qq.com
🔹《Runway Aleph模型实战:如何用3张分镜做出2分钟的AI短片》mp.weixin.qq.com
🔹《Midjourney V7产品创意设计演示与测评》mp.weixin.qq.com
🔹《Midjourney图片编辑器测试与应用-黑神话悟空绘图二创》mp.weixin.qq.com
🔹《AI高级珠宝设计与广告全流程》mp.weixin.qq.com
🔹《AI视频工具即梦“首尾帧”功能的应用与内容一致性的保持》mp.weixin.qq.com
🔹《流浪地球2》二创电影2.0制作复盘:mp.weixin.qq.com
🔹《Midjourney的“区域修改”与AI视频的“精准表达”》mp.weixin.qq.com
🔹《AI绘画的细节挑战与局部重绘的作用》m.okjike.com
🔹《如何使用New Bing设计图标和Logo》mp.weixin.qq.com
🔹《AI绘图、AI视频、AI音频Top1产品Midjourney、Runway、Eleven Labs三者关键功能分析》xiaobot.net
🎲其它
·《坦克世界》老司机,在美服带华人公会打过两年公会战
·最喜欢的动画是《攻壳机动队》
7 00
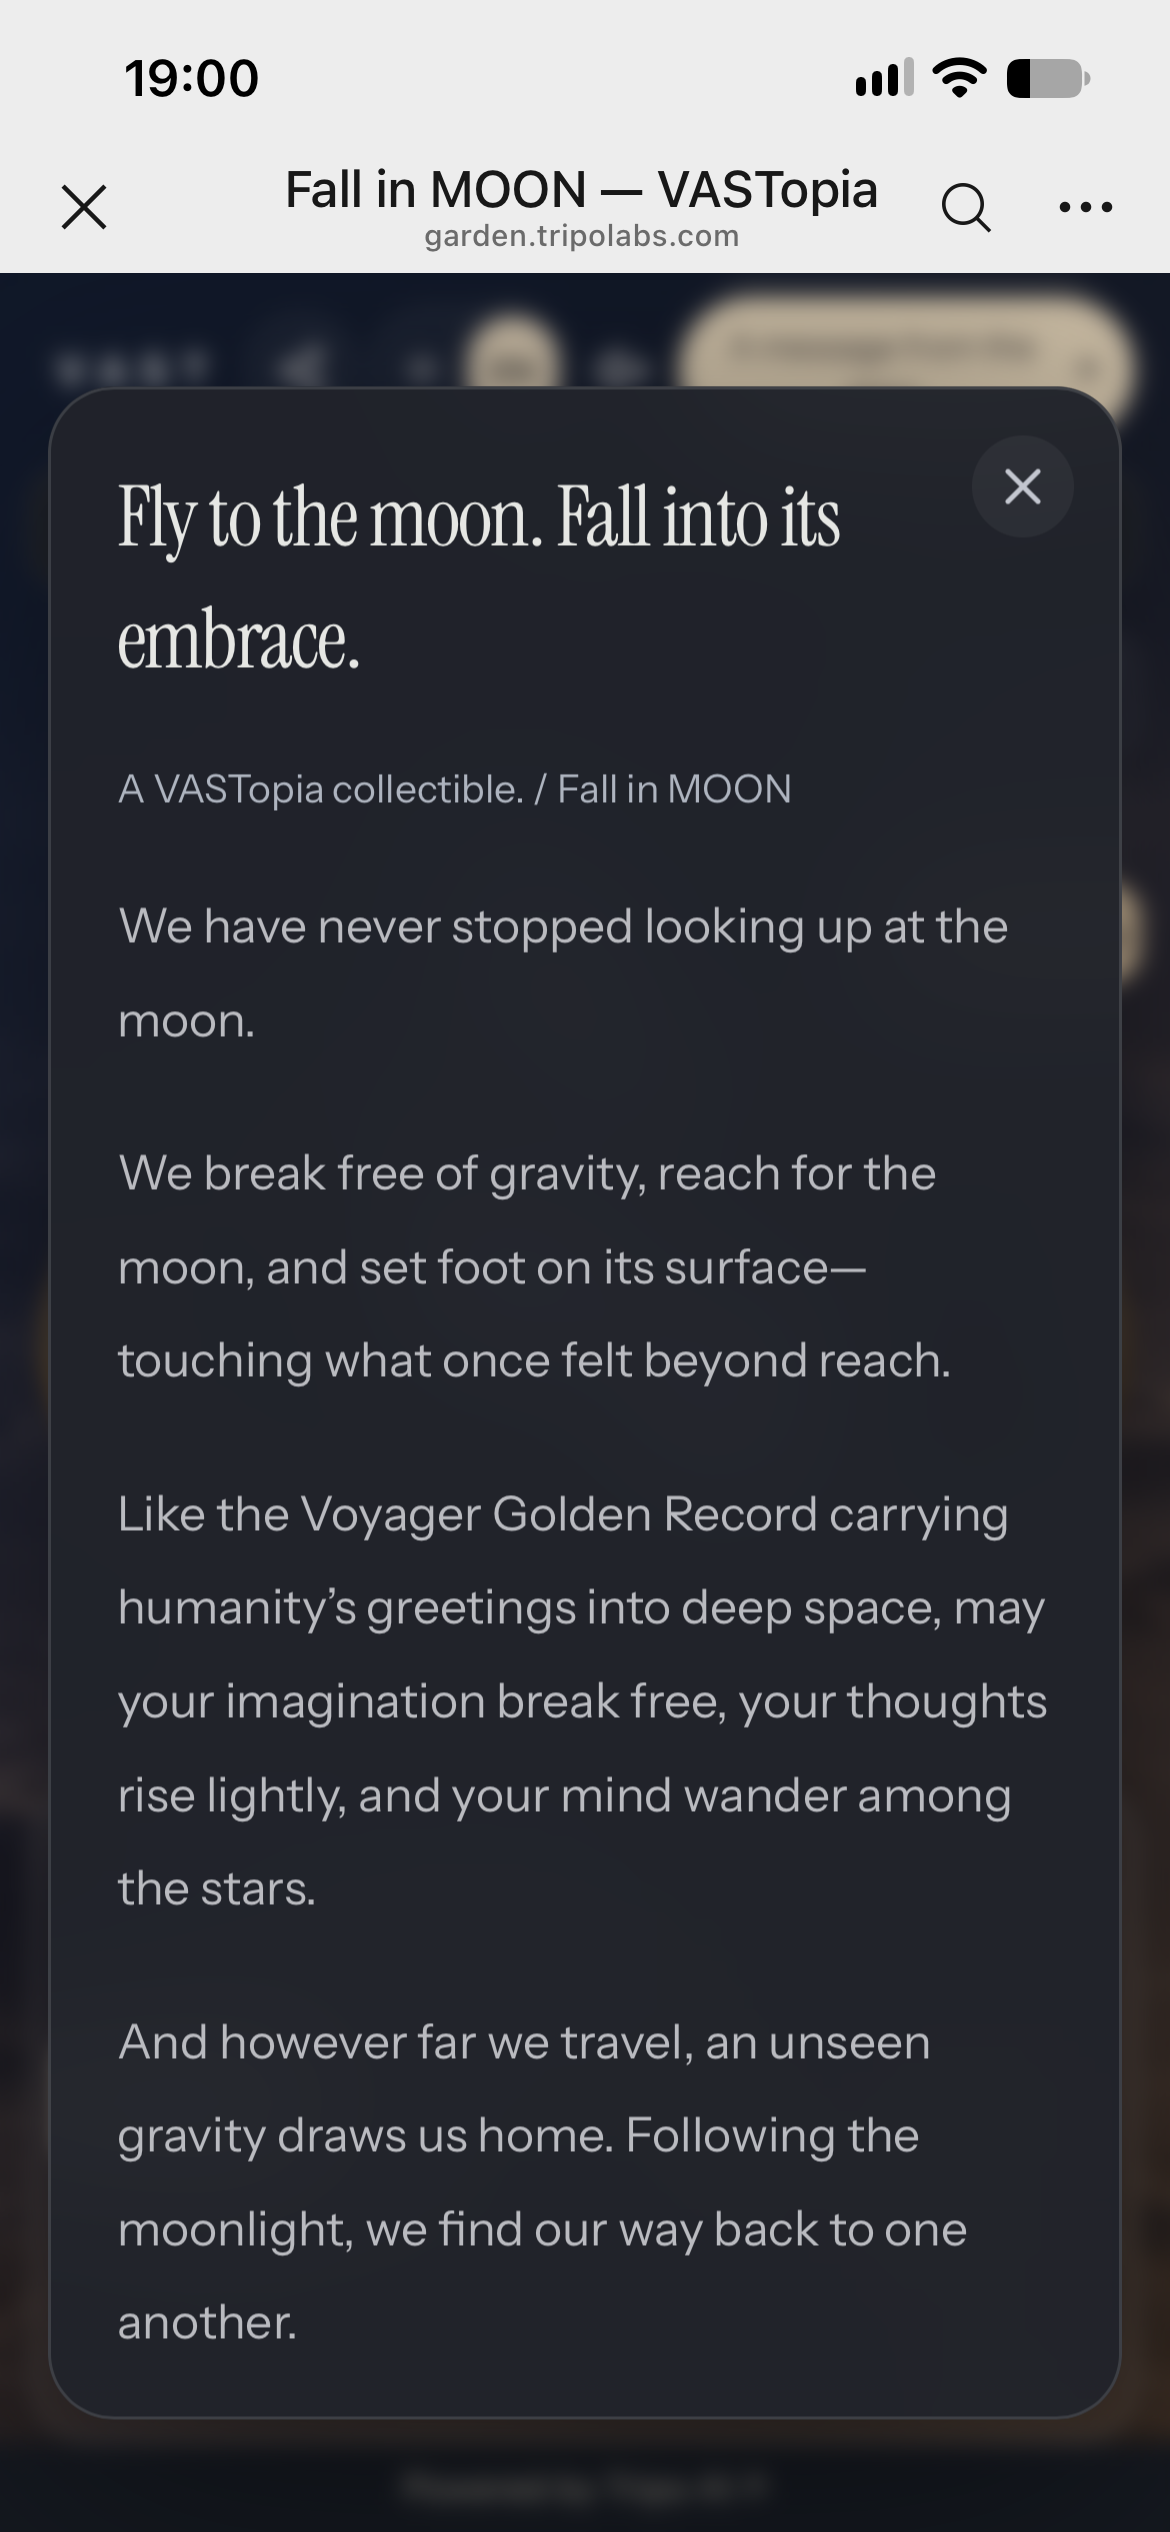
Tripo AI的中秋礼盒我愿给到一个夯🥳
整套3D打印的桌游,飞向月球的概念也很浪漫。最近从GPT-6到Opus 5.5,内容的边界越来越模糊了,想搓个什么东西只要舍得订阅费也越来越容易,社媒信息流里塞满了各种Agent快速实现的创意,我其实蛮焦虑的,AI进化的速度也未免太快了。或许越是这种时候,越需要提醒自己探索本身的乐趣,最重要的还是要玩得开心。
整套3D打印的桌游,飞向月球的概念也很浪漫。最近从GPT-6到Opus 5.5,内容的边界越来越模糊了,想搓个什么东西只要舍得订阅费也越来越容易,社媒信息流里塞满了各种Agent快速实现的创意,我其实蛮焦虑的,AI进化的速度也未免太快了。或许越是这种时候,越需要提醒自己探索本身的乐趣,最重要的还是要玩得开心。


1 00

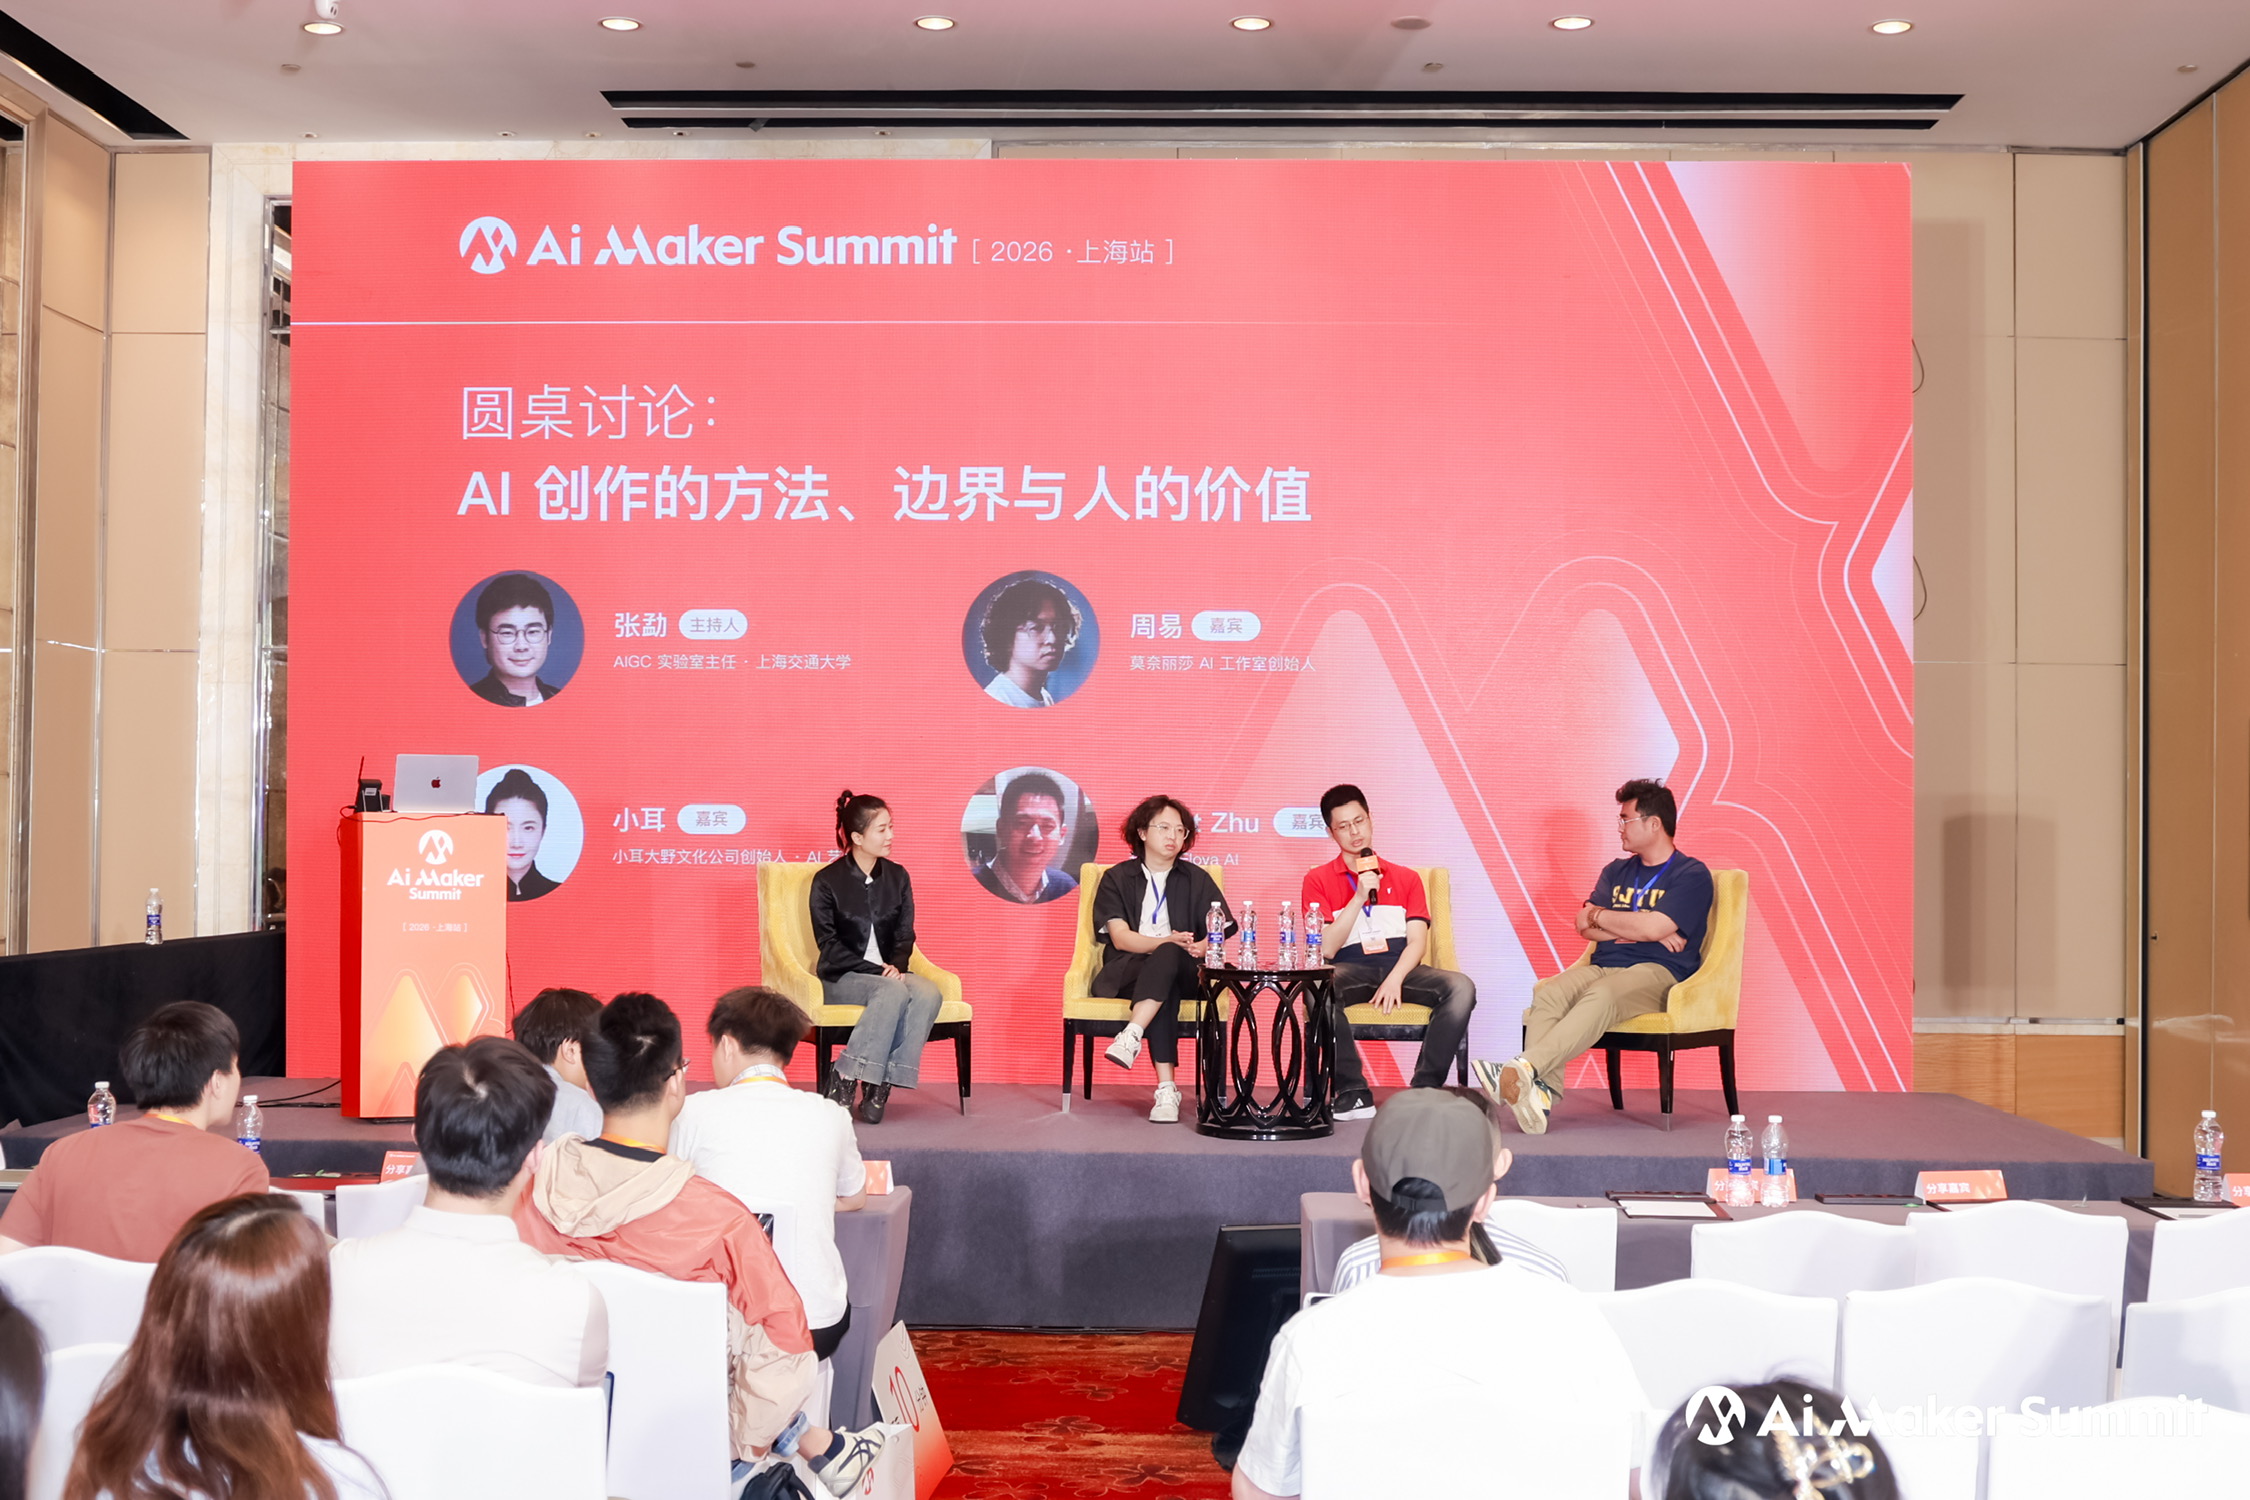
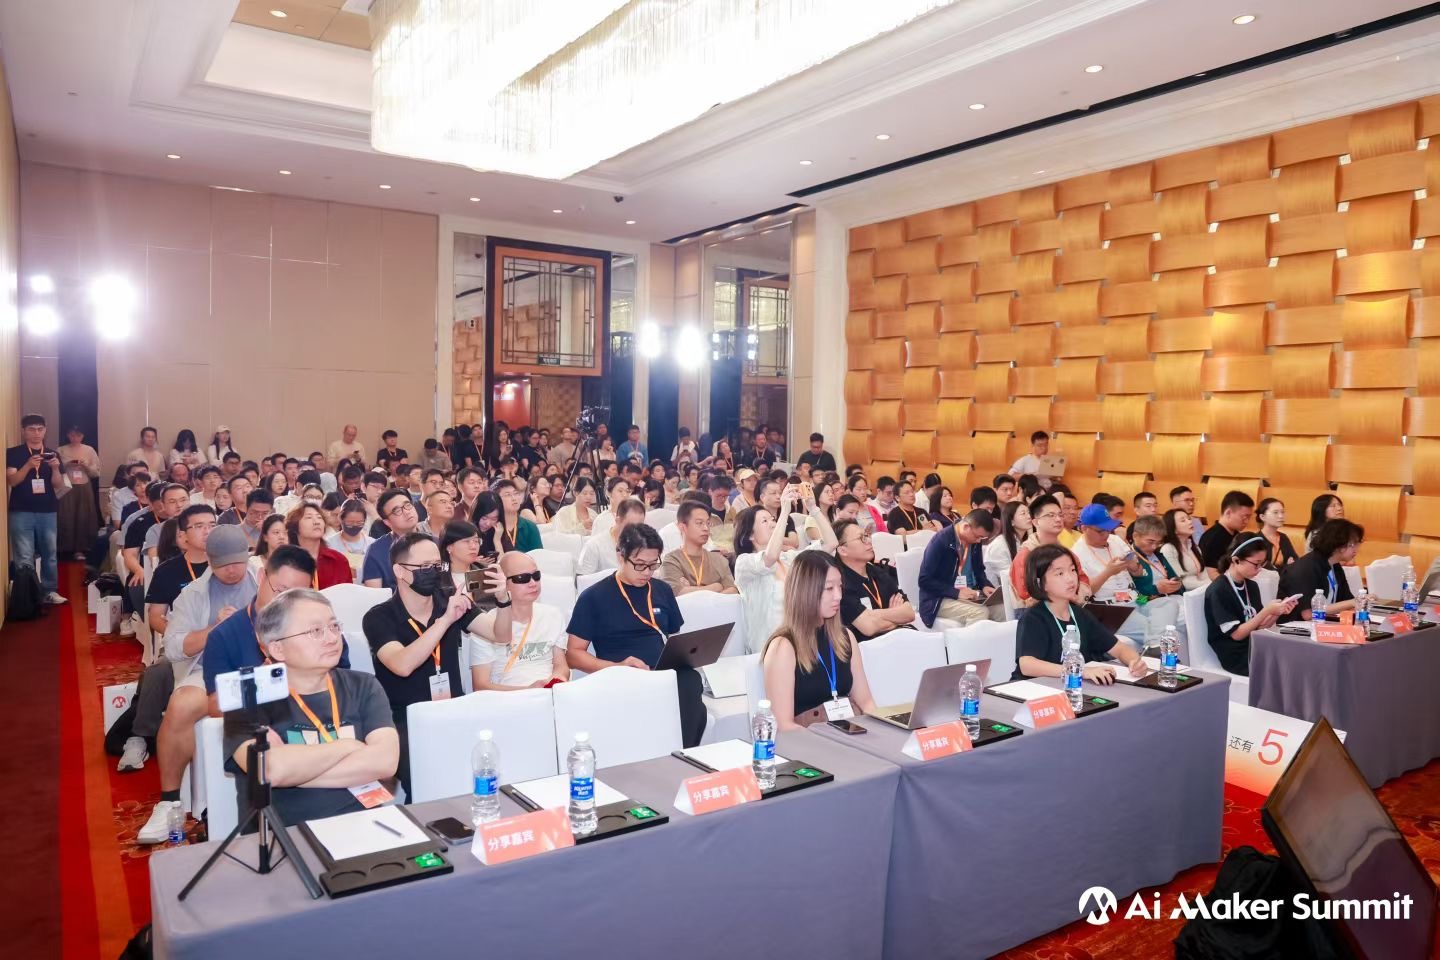
周末在AI Maker Summit上海站做了一些分享,感谢@AI产品阿颖 的组织和邀请,听了很多来自一线的AI实践,也认识了很多新朋友。



3 00


